ㅇ ㅂㅇ
유저를 생성한 뒤 유저에게는 기본적인 권한(접속, 테이블 생성)을 부여해야 함
SQL>GRANT connect, resource TO 유저명
웹 페이지는 보통 아이디의 무결성을 위해 비밀번호를 해쉬코드 알고리즘으로 저장함
오라클에서 해쉬코드로 저장하기 위해서는 그에 따른 권한을 부여 해주어야 함
명령어는
SQL>GRANT EXECUTE ON DBMS_CRYPTO TO [유저명];
이 권한을 주어야 해쉬 코드 함수를 사용 가능하게 하며 해쉬 코드 암호화 알고리즘으로는
위와 같이 있으며 dual 대신 테이블 명을 입력하면 된다.
오라클에서 순번을 사용 할 때 쓰는 시퀀스를 사용 할 때 이 또한 권한을 부여해주어야 함
시퀀스 권한에는 시퀀스의 값을 변하게(증감) 할 수 있는 권한, 시퀀스 변경 권한, 두가지 권한을 모두 갖는 권한이 있음.
GRANT [SELECT, SEQUENCE, ALTER] ON 소유계정.시퀀스명 TO 계정명;
- SELECT : CURRVAL과 NEXTVAL을 사용 할 수 있는 권한
- ALTER : SEQUENCE 변경 권한
- SEQUENCE : ALTER와 SELECT 두가지 권한
select sequence_owner from dba_sequences where sequence_name = '시퀀스명';
2015년 3월 26일 목요일
2015년 3월 24일 화요일
오라클의 개념_12
ㅇ ㅂㅇ
테이블 관리
사용자 데이터 저장오라클 데이터베이스에서는 여러 가지 방법으로 사용자 데이터를 저장할 수 있습니다.
• 일반 테이블
• 분할 테이블
• 인덱스 구성 테이블
• 클러스터화된 테이블
일반 테이블
대개 "테이블"이라고 하는 일반 테이블은 사용자 데이터를 저장하는 데 가장 일반적으로 사용되는 폼이며 기본 테이블이고 이 단원에서 주로 설명됩니다. 데이터베이스 관리자는 테이블의 행 분산에 대해 매우 제한된 제어를 수행합니다. 행은 테이블의 작업에 따라 임의의 순서로 저장됩니다.
분할 테이블
분할 테이블에서는 크기를 조정할 수 있는 응용 프로그램을 구축할 수 있습니다. 분할 테이블은 다음 특성을 가집니다.
• 분할 테이블에는 하나 이상의 분할 영역이 있으며 각 분할 영역은 범위 분할, 해시 분할, 조합 분할 또는 목록 분할을 사용하여 분할된 행을 저장합니다.
• 분할 테이블의 각 분할 영역은 세그먼트며 다른 테이블스페이스에 있을 수 있습니다.
• 분할 영역은 여러 프로세스를 동시에 사용하여 질의하거나 조작할 수 있는 대형 테이블에 유용합니다.
• 테이블 내의 분할 영역 관리에 특수 명령을 사용할 수 있습니다.
인덱스 구성 테이블
인덱스 구성 테이블은 하나 이상의 열에 기본 키 인덱스를 가진 힙 테이블과 유사하지만 테이블과 B 트리 인덱스에 대해 별도의 저장 영역 두 개를 유지 관리하는 대신 테이블의 기본키와 기타 열 값을 포함한 단일 B 트리만을 유지 관리합니다. PCTTHRESHOLD 값이 설정되고 오버플로우 영역이 필요한 더 긴 길이의 행 때문에 오버플로우 세그먼트가 존재할 수 있습니다.
인덱스 구성 테이블에서는 정확한 일치 및 범위 검색을 포함한 질의에 대해 빠른 키 기반의 테이블 데이터 액세스를 제공합니다.
또한 키 열이 테이블과 인덱스에서 중복되지 않으므로 필요한 저장 영역이 감소됩니다. 나머지 비 키 열은 인덱스 항목이 매우 크지 않으면 인덱스에 저장되며 매우 크면 Oracle 서버에서는 이 문제를 처리하기 위해 OVERFLOW 절을 제공합니다.
클러스터화된 테이블
클러스터화된 테이블에서는 테이블 데이터를 저장하기 위해 선택적인 방식을 제공합니다.
클러스터는 동일한 데이터 블록을 공유하는 테이블 또는 테이블 그룹으로 구성되며 이 테이블은 공통 열을 공유하고 자주 함께 사용되므로 함께 그룹화됩니다.
클러스터는 다음 특성을 가집니다.
• 클러스터는 함께 저장되어야 하는 행을 식별하는 데 사용되는 클러스터 키를 가집니다.
• 클러스터 키는 하나 이상의 열로 구성할 수 있습니다.
• 클러스터의 테이블은 클러스터 키에 대응하는 열을 가집니다.
• 클러스터화는 테이블을 사용하는 응용 프로그램에 그대로 적용되는 방식이며 클러스터화된 테이블의 데이터는 일반 테이블에 저장된 데이터처럼 조작할 수 있습니다.
• 클러스터 키의 열 하나를 갱신하면 행이 이전될 수 있습니다.
• 클러스터 키는 기본 키에 대해 독립적입니다. 클러스터의 테이블은 기본 키를 가질 수 있으며 이 기본 키는 클러스터 키 또는 다른 열 집합입니다.
• 클러스터는 대개 성능 향상을 위해 생성합니다. 클러스터화된 데이터에 대한 임의의 액세스 속도는 향상되지만 클러스터화된 테이블에서의 전체 테이블 스캔은 대개 속도가 느려집니다.
• 클러스터는 논리적 구조에 영향을 주지 않고 테이블의 물리적 저장 영역을 다시 정규화합니다.
Oracle 내장 데이터 유형
Oracle 서버에서는 스칼라 데이터, 모음 및 관계를 저장하는 여러 내장 데이터 유형을 제공합니다.
스칼라 데이터 유형
문자 데이터: 데이터베이스에 고정 길이 문자열이나 가변 길이 문자열로 문자 데이터를 저장할 수 있습니다.
CHAR나 NCHAR와 같은 고정 길이 문자 데이터 유형은 공백 채움을 사용하여 저장됩니다.
NCHAR는 고정 너비 또는 가변 너비 문자 집합의 저장을 가능하게 하는 Globalization
Support 데이터 유형입니다. 최대 크기는 한 문자를 저장하는 데 필요한 바이트 수에 따라 결정되며 행당 최대 한계는 2,000바이트입니다. 기본값은 문자 집합에 따라 한 문자 또는 한 바이트입니다.
가변 길이 문자 데이터 유형은 실제 열 값을 저장하는 데 필요한 바이트 수만을 사용하고 각 행에 대해 크기가 다를 수 있으며 최대 4,000바이트까지 가능합니다. VARCHAR2와 NVARCHAR2는 가변 길이 문자 데이터 유형의 예입니다.
숫자 데이터 유형: 오라클 데이터베이스에서 숫자는 항상 가변 길이 데이터로 저장되며 최대 38자리까지 저장할 수 있습니다. 숫자 데이터 유형에는 다음이 필요합니다.
• 지수용으로 한 바이트
• 가수에서 두 자리마다 한 바이트
• 자릿수가 38바이트 미만인 경우 음수용으로 한 바이트
DATE 데이터 유형: Oracle 서버에서는 날짜를 일곱 바이트의 고정 길이 필드에 저장하며
Oracle DATE에는 항상 시간이 포함됩니다.
TIMESTAMP 데이터 유형: 이 데이터 유형에는 날짜와 소수점 아홉 자리까지 표시되는 초를 포함한 시간이 저장됩니다. TIMESTAMP WITH TIME ZONE 및 TIMESTAMP WITH LOCAL TIME ZONE은 일광 절약 시간과 같은 항목을 요소화하기 위해 시간 영역을 사용할 수 있습니다. TIMESTAMP 및 TIMESTAMP WITH LOCAL TIME ZONE은 기본 키에서 사용할 수 있지만 TIMESTAMP WITH TIME ZONE은 사용할 수 없습니다.
RAW 데이터 유형: 이 데이터 유형은 작은 이진 데이터를 저장할 수 있습니다. RAW 데이터가 네트워크에서 시스템 간에 전송되거나 Oracle 유틸리티를 사용하여 한 데이터베이스에 다른 데이터베이스로 이동될 경우 Oracle 서버는 문자 집합 변환을 수행하지 않습니다. 실제 열 값을 저장하는 데 필요한 바이트 수는 각 행마다 크기가 다르며 최대 2,000바이트까지 가능합니다.
LONG, LONG RAW및LOB(Large Object) 데이터 유형
Oracle에서는 LOB을 저장하기 위해 다음 여섯 가지의 데이터 유형을 제공합니다.
• 대형 고정 너비 문자 데이터를 저장하기 위한 CLOB 및 LONG
• 대형 고정 너비 국가별 문자 집합 데이터를 저장하기 위한 NCLOB
• 구조화되지 않은 데이터를 저장하기 위한 BLOB 및 LONG RAW
• 구조화되지 않은 데이터를 운영 체제 파일에 저장하기 위한 BFILE
LONG 및 LONG RAW 데이터 유형은 이전에는 이진 이미지, 문서 또는 지리 정보와 같은 구
조화되지 않은 데이터에 사용되었고 주로 역 호환성을 위해 제공됩니다. 이러한 데이터 유
형은 LOB 데이터 유형으로 교체되었습니다. LOB 데이터 유형은 LONG 및 LONG RAW와 구
분되고 교환할 수 없습니다. LOB은 LONG API(응용 프로그램 프로그래밍 인터페이스)를 지
원하지 않으며 그 반대의 경우도 마찬가지입니다.
이전 유형(LONG 및 LONG RAW)과 비교하면서 LOB 기능을 설명하는 것이 도움이 됩니다.
이후부터 LONG은 LONG과 LONG RAW를, LOB은 모든 LOB 데이터 유형을 가리킵니다.
크기가 VARCHAR2 데이터 유형에 대해 최대 크기(4,000바이트)보다 작지 않으면 LOB에서
는 테이블에 위치자를 테이블 외의 다른 위치에 데이터를 저장하지만 LONG에서는 모든
데이터를 순서대로 저장합니다. 또한 LOB에서는 데이터를 별도의 세그먼트 및 테이블스
페이스 또는 호스트 파일에 저장할 수 있습니다.
LOB에서는 NCLOB을 제외하고 객체 유형 속성과 복제를 지원하지만 LONG에서는 지원하
지 않습니다.
LONG은 기본적으로 다른 블록에 저장된 다음 행 조각을 가리키는 다른 블록의 행 조각과
함께 체인화된 행 조각으로 저장됩니다. 따라서 LONG은 순차적으로 액세스되어야 합니다.
반면 LOB에서는 파일 형식 인터페이스를 통해 데이터에 대한 임의의 조각 방식 액세스를
지원합니다.
ROWID 및UROWID 데이터유형
ROWID는 테이블의 다른 열과 함께 질의할 수 있는 데이터 유형이며 다음 특성을 가집니다.
• ROWID는 데이터베이스에 있는 각 행에 대한 고유 식별자입니다.
• ROWID는 명시적으로 열 값으로서 저장되지 않습니다.
• ROWID는 행의 물리적 주소를 직접 부여하지는 않지만 행 위치를 지정하는 데 사용될 수 있습니다.
• ROWID를 사용하면 가장 빨리 테이블의 행을 액세스할 수 있습니다.
• ROWID는 주어진 키 값의 집합을 가진 행을 지정하기 위해 인덱스에 저장됩니다.
Oracle8.1에서 Oracle 서버는 범용 ROWID 또는 UROWID라고 하는 단일 데이터 유형을 제공하여 Oracle 테이블이 아닌 외래 테이블의 ROWID를 지원하고 모든 종류의 ROWID를 저장 할 수 있습니다. 예를 들어, UROWID 데이터 유형은 IOT(인덱스 구성 테이블)에 저장된 행에 대해 ROWID를 저장하는 데 필요합니다. UROWID를 사용하려면 COMPATIBLE 매개변수의 값을 Oracle8.1 이상으로 설정해야 합니다.
모음데이터유형
테이블의 주어진 행에 대해 반복적인 데이터를 저장할 수 있는 두 가지 모음 데이터 유형이 있습니다. Oracle8i 전의 Oracle 버전에서는 모음을 정의하고 사용하려면 Object 옵션이 필
요했습니다. 이러한 유형에 대한 간략한 설명은 다음과 같습니다.
VARRAY(가변 배열): 가변 배열은 고객 전화 번호와 같은 작은 수의 요소를 포함하고 있는
목록을 저장하는 데 유용합니다.
VARRAY에는 다음 특성이 있습니다.
• 배열은 순서를 지정한 데이터 요소 집합입니다.
• 주어진 배열의 모든 요소는 동일한 데이터 유형입니다.
• 각 요소에는 인덱스가 있으며 이 인덱스는 배열 요소의 위치에 대응하는 번호입니다.
• 배열 요소의 수는 배열의 크기를 결정합니다.
• Oracle 서버에서는 배열이 가변 크기가 될 수 있으므로 VARRAY라고 하지만 최대 크기는 배열 유형 선언 시 지정되어야 합니다.
중첩 테이블: 중첩 데이블을 사용하면 테이블을 테이블 내의 한 열로 정의할 수 있습니다.
중첩 테이블은 주문의 여러 항목처럼 많은 레코드를 가진 집합을 저장하는 데 사용될 수 있
습니다.
중첩 테이블에는 대개 다음 특성이 있습니다.
• 중첩 테이블은 순서를 지정하지 않은 레코드나 행의 집합입니다.
• 중첩 테이블의 행은 동일한 구조를 갖습니다.
• 중첩 테이블의 행은 상위 테이블에 있는 해당 행의 포인터와 함께 상위 테이블과는
별도로 저장됩니다.
• 중첩 테이블의 저장 영역 특성은 데이터베이스 관리자가 정의할 수 있습니다.
• 중첩 테이블에 대해 미리 정의된 최대 크기는 없습니다.
REF(관계데이터유형)
관계 유형은 데이터베이스 내에서 포인터로 사용되며 이러한 유형을 사용하려면 Object 옵션이 필요합니다. 예를 들어, 주문된 각 항목은 제품 코드를 저장하지 않고도 PRODUCTS 테이블의 행을 가리키거나 참조할 수 있습니다.
Oracle 사용자정의데이터유형:
Oracle 서버에서는 사용자가 추상 데이터 유형을 정의하여 응용 프로그램 내에서 사용할
수 있습니다.
ROWID 형식
확장된 ROWID는 디스크에 10 바이트의 저장 영역이 필요하며 18문자를 사용하여 표시됩
니다. ROWID는 다음 요소로 구성됩니다.
• 데이터 객체 번호: 테이블이나 인덱스와 같은 각 데이터 객체가 생성될 때 지정되고 데이터베이스 내에서 고유합니다.
• 상대 파일 번호: 테이블스페이스 내의 각 파일에서 고유합니다.
• 블록 번호: 파일 내의 행을 포함하는 블록의 위치를 나타냅니다.
• 행 번호: 블록 헤더에 있는 행 디렉토리 슬롯의 위치를 식별합니다.
내부적으로 데이터 객체 번호에는 32비트, 상대 파일 번호에는 10비트, 블록 번호에는 22비
트, 행 번호에는 16비트가 필요하며 모두 합하여 총 80비트 또는 10바이트입니다.
확장된 ROWID는 데이터 객체 번호에 여섯 자리, 상대 파일 번호에 세 자리, 블록 번호에 여
섯 자리, 행 번호에 세 자리를 사용하는 기본 64 암호화 체계를 사용하여 표시됩니다. 기본
64 암호화 체계는 아래의 예에서처럼 A-Z, a-z, 0-9, / 등 총 64문자를 사용합니다.
SQL> SELECT department_id, rowid FROM hr.departments;
DEPARTMENT_ID ROWID
------------- ------------------
10 AAABQMAAFAAAAA6AAA
20 AAABQMAAFAAAAA6AAB
30 AAABQMAAFAAAAA6AAC
40 AAABQMAAFAAAAA6AAD
50 AAABQMAAFAAAAA6AAE
60 AAABQMAAFAAAAA6AAF
…
이 예에 대한 설명은 다음과 같습니다.
• AAABQM는 데이터 객체 번호입니다.
• AAF는 상대 파일 번호입니다.
• AAAAA6는 블록 번호입니다.
• AAA는 ID=10인 부서에 대한 행 번호입니다.
Oracle7과 그 이전 버전의 제한된ROWID
Oracle8 이전의 오라클 데이터베이스 버전에서는 제한된 ROWID 형식을 사용했습니다. 제
한된 ROWID는 내부적으로 여섯 바이트만을 사용했고 데이터 객체 번호를 포함하지 않았
습니다. 이러한 형식은 파일 번호가 데이터베이스 내에서 고유하므로 Oracle7 이전 버전에
서 승인되었습니다. 따라서 이전 버전에서는 1,022개를 넘는 데이터 파일을 허용하지 않았
지만 이번 버전에서는 테이블스페이스에 대한 제한입니다.
Oracle8에서는 테이블스페이스 상대 파일 번호를 사용하여 이러한 제한을 제거했지만 제
한된 ROWID는 모든 인덱스 항목이 동일한 세그먼트 내의 행을 참조하는 분할되지 않은 테
이블의 분할되지 않은 인덱스와 같은 객체에서 여전히 사용됩니다.
ROWID를사용한행위치지정
세그먼트는 데이터 객체 번호를 사용하여 테이블스페이스 하나에만 상주할 수 있으므로
Oracle 서버에서는 행을 포함한 테이블스페이스를 결정할 수 있습니다.
테이블스페이스 내의 상대 파일 번호는 파일의 위치, 블록 번호는 행을 포함한 블록의 위치,
행 번호는 행에 대한 행 디렉토리 항목의 위치를 지정하는 데 사용됩니다.
행 디렉토리 항목은 행의 시작 위치를 지정하는 데 사용될 수 있습니다.
따라서 ROWID는 데이터베이스 내의 행 위치를 지정하는 데 사용될 수 있습니다.
행의 구조
행 데이터는 가변 길이 레코드로 데이터베이스 블록에 저장됩니다. 행에 대한 열은 대개 정
의된 순서대로 저장되며 후행 NULL 열은 저장되지 않습니다.• 행 헤더: 행의 열 개수, 체인 정보, 행 잠금 상태를 저장하는 데 사용됩니다.
• 행 데이터: Oracle 서버에서는 각 열에 대해 열 길이와 값을 저장합니다. 열에 250바이
트를 초과하는 저장 영역이 필요한 경우 열 길이를 저장하는 데에는 한 바이트가 필
요합니다. 이 때 세 바이트가 열 길이를 위해 사용됩니다. 열 값은 열 길이 바이트 바
로 다음에 저장됩니다.
인접한 행 간에는 공백이 필요하지 않습니다. 블록의 각 행에는 행 디렉토리에 슬롯이 있으
며 디렉토리 슬롯은 행의 처음을 가리킵니다.
테이블 생성
CREATE TABLE 명령은 관계형 테이블 또는 객체 테이블을 생성하는 데 사용됩니다.
관계형 테이블: 이 테이블은 사용자 데이터를 유지하는 기본 구조입니다.
객체 테이블: 열 정의에 객체 유형을 사용하는 테이블입니다. 객체 테이블은 특정 유형의
객체 인스턴스를 저장하기 위해 명시적으로 정의되는 테이블입니다.
테이블생성지침
• 테이블을 별도의 테이블스페이스에 둡니다.
• 단편화를 방지하려면 지역적으로 관리되는 테이블스페이스를 사용합니다.
다음 예제는 데이터 딕셔너리 관리 테이블스페이스에서 DEPARTMENTS 테이블을 생성합
니다.
SQL> CREATE TABLE hr.departments(
2 department_id NUMBER(4),
3 department_name VARCHAR2(30),
4 manager_id NUMBER(6),
5 location_id NUMBER(4))
6 STORAGE(INITIAL 200K NEXT 200K
7 PCTINCREASE 0 MINEXTENTS 1 MAXEXTENTS 5)
8 TABLESPACE data;
위 구문은 CREATE TABLE 절의 일부입니다.
STORAGE 절
STORAGE 절은 테이블에 대해 저장 영역 특성을 지정합니다. 첫번째 확장 영역에 할당된 저장 영역은 200KB입니다. 두번째 확장 영역이 필요한 경우 NEXT 값으로 정의된 200KB의
저장 영역이 생성됩니다. 세번째 확장 영역이 필요한 경우에는 PCTINCREASE가 0으로 설
정되었으므로 200KB의 저장 영역이 생성됩니다. 사용 가능한 확장 영역 수의 최대값은 5이
고 최소값은 1로 설정됩니다.
• MINEXTENTS: 할당되는 확장 영역의 최소 개수입니다.
• MAXEXTENTS: 할당되는 확장 영역의 최대 개수입니다. MINEXTENTS가 1보다 큰 값
으로 지정되고 테이블스페이스에 데이터 파일이 두 개 이상 포함되면 확장 영역이 다
른 데이터 파일로 분산됩니다.
• PCTINCREASE: NEXT 확장 영역 이후 확장 영역 크기의 증가율입니다.
테이블에 대해 physical_attributes_clause에서 블록 활용 매개변수를 지정할 수 도 있습니다.
• PCTFREE: 테이블의 각 데이터 블록에 있는 공간의 비율을 지정합니다. PCTFREE의 값은 0에서 99까지 설정할 수 있습니다. 0으로 설정하면 전체 블록이 새 행을 삽입하여 채워질 수 있다는 것을 의미합니다. 기본값인 10으로 설정하면 기존 행을 갱신하기 위해 각 블록의 10%를 예약하고 새 행을 삽입하여 각 블록을 최대 90%까지 채울 수 있습니다.
• PCTUSED: 테이블의 각 데이터 블록을 유지 관리하기 위해 사용되는 공간의 최소 비율을 지정합니다. 사용된 공간이 PCTUSED보다 작아지면 행 삽입을 위해 블록이 사용됩니다. PCTUSED는 0에서 99까지 정수로 지정되며 기본값은 40입니다.
PCTFREE와 PCTUSED를 함께 사용하여 새 행이 기존 데이터 블록에 삽입될지 새 블록에 삽입될지 여부를 결정합니다. 이 두 값의 합은 100이하가 되어야 합니다. 이러한 매개변수는 테이블의 공간을 보다 효과적으로 활용하는 데 사용됩니다.
• INITRANS: 테이블에 할당된 각 데이터 블록 내의 초기 할당 트랜잭션 항목 수를 지정합니다. 이 값은 1에서 255까지이며 기본값은 1입니다. 최소 개수의 동시 트랜잭션으로 블록을 갱신할 수 있어야 합니다. 일반적으로 기본값을 변경하지 말아야 합니다.
• MAXTRANS: 테이블에 할당된 데이터 블록을 갱신할 수 있는 동시 트랜잭션의 최대 개수를 지정합니다. 이 제한은 질의에는 적용되지 않습니다. 이 값은 1에서 255까지이며 기본값은 데이터 블록 크기에 따라 달라집니다.
TABLESPACE 절
TABLESPACE 절은 테이블이 생성되는 테이블스페이스를 지정합니다. 예제에 있는 테이블
은 데이터 테이블스페이스 내에 상주합니다. TABLESPACE를 생략한 경우 Oracle은 테이블
을 포함하는 스키마 소유자의 기본 테이블스페이스에 객체를 생성합니다.
테이블 생성 : 지침
실행 취소 세그먼트, 임시 세그먼트 및 인덱스를 포함하는 테이블스페이스가 아닌 별도의 테이블스페이스에 테이블을 둡니다.
단편화를 방지하려면 지역적으로 관리되는 테이블스페이스에 테이블을 넣으십시오.
임시 테이블 생성
임시 테이블을 생성하여 트랜잭션 또는 세션 동안에만 존재하는 세션 전용 데이터를 보유
할 수 있습니다.
CREATE GLOBAL TEMPORARY TABLE 명령은 트랜잭션별 또는 세션별로 임시 테이블을 생성합니다. 세션별 임시 테이블의 경우에는 데이터가 해당 세션 동안에 존재하지만 트랜잭션별 임시 테이블의 경우에는 데이터가 트랜잭션 동안에 존재합니다. 세션의 데이터는 세션 전용이며 각 세션은 자체 데이터만을 보고 수정할 수 있습니다. DML 잠금은 임시 테이블의 데이터에는 적용되지 않습니다. 행의 기간을 제어하는 절은 다음과 같습니다.
• ON COMMIT DELETE ROWS: 트랜잭션 내에서만 행을 볼 수 있도록 지정합니다.
• ON COMMIT PRESERVE ROWS: 전체 세션에서 행을 볼 수 있도록 지정합니다.
임시 테이블에 인덱스, 뷰 및 트리거를 생성하고 또한 Export 유틸리티와 Import 유틸리티를 사용하여 임시 테이블 정의를 엑스포트하고 임포트할 수 있습니다. 그러나 ROWS 옵션을 사용하더라도 데이터는 엑스포트되지 않습니다. 임시 테이블의 정의는 모든 세션에서 볼 수 있습니다.
PCTFREE 및 PCTUSED 설정
PCTFREE 설정
PCTFREE가 높을수록 데이터베이스 블록 내에 갱신할 수 있는 여유 공간이 많아집니다. 테
이블에 다음이 포함되어 있을 경우 높은 값을 설정합니다.
• 처음에는 NULL이고 이후에 값을 가진 열로 갱신되는 열
• 갱신 결과 크기가 증가할 가능성이 있는 열
PCTFREE가 높을수록 블록 밀도가 낮아져서 각 블록은 적은 행을 수용할 수 있습니다.
위에서 지정한 공식은 행 성장에 대비하여 블록에 사용 가능 영역이 충분한지 확인합니다.
PCTUSED 설정
PCTUSED를 설정하여 평균 행을 수용할 만큼 충분한 공간이 있을 때만 사용 가능 영역 목
록에 블록을 반환함을 확인합니다. 사용 가능 영역 목록의 블록에 행을 삽입하기 위한 충분
한 공간이 없을 경우 Oracle 서버에서는 사용 가능 영역 목록의 다음 블록을 조회합니다. 이
러한 선형 스캔은 공간이 충분한 블록을 찾을 때까지 또는 목록의 끝에 도달할 때까지 계속
됩니다. 주어진 공식을 사용하면 필수의 사용 가능 영역이 있는 블록을 찾을 가능성이 높아
져 스캔 시간이 줄어듭니다.
-----------------------------------------------------------------------------------------------------------------
실습
List partition table 생성과 관리
>명령어
SELECT TABLE_OWNER, TABLE_NAME, PARTITION_NAME, HIGH_VALUE, TABLESPACE_NAME
FROM DBA_TAB_PARTITIONS;
- 테이블의 파티션을 조회함
- HIGH_VALUE : 리스트 파티션에서는 일치하는 값, 범위 파티션에서는 상한 값을 나타냄
SELECT OWNER, NAME, COLUMN_NAME
FROM DBA_PART_KEY_COLUMNS;
- 파티션의 기준이 되는 column을 조회
CREATE TABLE
(
..................
)
PARTITION BY LIST ()
(
PARTITION VALUES () [ TABLESPACE ].
............
);
- Partition으로 구현된 table을 생성
- LIST 절에 collumn명은 여러 개 지정 할 수 없음.
ALTER TABLE
ADD PARTITION VALUES () [ TABLESPACE ];
- table에 partition을 추가
ALTER TABLE
DROP PARTITION;
- Partition을 삭제
SELECT tablespace_name, bytes, file_name FROM dba_data_files;
테이블 관리
사용자 데이터 저장오라클 데이터베이스에서는 여러 가지 방법으로 사용자 데이터를 저장할 수 있습니다.
• 일반 테이블
• 분할 테이블
• 인덱스 구성 테이블
• 클러스터화된 테이블
일반 테이블
대개 "테이블"이라고 하는 일반 테이블은 사용자 데이터를 저장하는 데 가장 일반적으로 사용되는 폼이며 기본 테이블이고 이 단원에서 주로 설명됩니다. 데이터베이스 관리자는 테이블의 행 분산에 대해 매우 제한된 제어를 수행합니다. 행은 테이블의 작업에 따라 임의의 순서로 저장됩니다.
분할 테이블
분할 테이블에서는 크기를 조정할 수 있는 응용 프로그램을 구축할 수 있습니다. 분할 테이블은 다음 특성을 가집니다.
• 분할 테이블에는 하나 이상의 분할 영역이 있으며 각 분할 영역은 범위 분할, 해시 분할, 조합 분할 또는 목록 분할을 사용하여 분할된 행을 저장합니다.
• 분할 테이블의 각 분할 영역은 세그먼트며 다른 테이블스페이스에 있을 수 있습니다.
• 분할 영역은 여러 프로세스를 동시에 사용하여 질의하거나 조작할 수 있는 대형 테이블에 유용합니다.
• 테이블 내의 분할 영역 관리에 특수 명령을 사용할 수 있습니다.
인덱스 구성 테이블
인덱스 구성 테이블은 하나 이상의 열에 기본 키 인덱스를 가진 힙 테이블과 유사하지만 테이블과 B 트리 인덱스에 대해 별도의 저장 영역 두 개를 유지 관리하는 대신 테이블의 기본키와 기타 열 값을 포함한 단일 B 트리만을 유지 관리합니다. PCTTHRESHOLD 값이 설정되고 오버플로우 영역이 필요한 더 긴 길이의 행 때문에 오버플로우 세그먼트가 존재할 수 있습니다.
인덱스 구성 테이블에서는 정확한 일치 및 범위 검색을 포함한 질의에 대해 빠른 키 기반의 테이블 데이터 액세스를 제공합니다.
또한 키 열이 테이블과 인덱스에서 중복되지 않으므로 필요한 저장 영역이 감소됩니다. 나머지 비 키 열은 인덱스 항목이 매우 크지 않으면 인덱스에 저장되며 매우 크면 Oracle 서버에서는 이 문제를 처리하기 위해 OVERFLOW 절을 제공합니다.
클러스터화된 테이블
클러스터화된 테이블에서는 테이블 데이터를 저장하기 위해 선택적인 방식을 제공합니다.
클러스터는 동일한 데이터 블록을 공유하는 테이블 또는 테이블 그룹으로 구성되며 이 테이블은 공통 열을 공유하고 자주 함께 사용되므로 함께 그룹화됩니다.
클러스터는 다음 특성을 가집니다.
• 클러스터는 함께 저장되어야 하는 행을 식별하는 데 사용되는 클러스터 키를 가집니다.
• 클러스터 키는 하나 이상의 열로 구성할 수 있습니다.
• 클러스터의 테이블은 클러스터 키에 대응하는 열을 가집니다.
• 클러스터화는 테이블을 사용하는 응용 프로그램에 그대로 적용되는 방식이며 클러스터화된 테이블의 데이터는 일반 테이블에 저장된 데이터처럼 조작할 수 있습니다.
• 클러스터 키의 열 하나를 갱신하면 행이 이전될 수 있습니다.
• 클러스터 키는 기본 키에 대해 독립적입니다. 클러스터의 테이블은 기본 키를 가질 수 있으며 이 기본 키는 클러스터 키 또는 다른 열 집합입니다.
• 클러스터는 대개 성능 향상을 위해 생성합니다. 클러스터화된 데이터에 대한 임의의 액세스 속도는 향상되지만 클러스터화된 테이블에서의 전체 테이블 스캔은 대개 속도가 느려집니다.
• 클러스터는 논리적 구조에 영향을 주지 않고 테이블의 물리적 저장 영역을 다시 정규화합니다.
Oracle 내장 데이터 유형
Oracle 서버에서는 스칼라 데이터, 모음 및 관계를 저장하는 여러 내장 데이터 유형을 제공합니다.
스칼라 데이터 유형
문자 데이터: 데이터베이스에 고정 길이 문자열이나 가변 길이 문자열로 문자 데이터를 저장할 수 있습니다.
CHAR나 NCHAR와 같은 고정 길이 문자 데이터 유형은 공백 채움을 사용하여 저장됩니다.
NCHAR는 고정 너비 또는 가변 너비 문자 집합의 저장을 가능하게 하는 Globalization
Support 데이터 유형입니다. 최대 크기는 한 문자를 저장하는 데 필요한 바이트 수에 따라 결정되며 행당 최대 한계는 2,000바이트입니다. 기본값은 문자 집합에 따라 한 문자 또는 한 바이트입니다.
가변 길이 문자 데이터 유형은 실제 열 값을 저장하는 데 필요한 바이트 수만을 사용하고 각 행에 대해 크기가 다를 수 있으며 최대 4,000바이트까지 가능합니다. VARCHAR2와 NVARCHAR2는 가변 길이 문자 데이터 유형의 예입니다.
숫자 데이터 유형: 오라클 데이터베이스에서 숫자는 항상 가변 길이 데이터로 저장되며 최대 38자리까지 저장할 수 있습니다. 숫자 데이터 유형에는 다음이 필요합니다.
• 지수용으로 한 바이트
• 가수에서 두 자리마다 한 바이트
• 자릿수가 38바이트 미만인 경우 음수용으로 한 바이트
DATE 데이터 유형: Oracle 서버에서는 날짜를 일곱 바이트의 고정 길이 필드에 저장하며
Oracle DATE에는 항상 시간이 포함됩니다.
TIMESTAMP 데이터 유형: 이 데이터 유형에는 날짜와 소수점 아홉 자리까지 표시되는 초를 포함한 시간이 저장됩니다. TIMESTAMP WITH TIME ZONE 및 TIMESTAMP WITH LOCAL TIME ZONE은 일광 절약 시간과 같은 항목을 요소화하기 위해 시간 영역을 사용할 수 있습니다. TIMESTAMP 및 TIMESTAMP WITH LOCAL TIME ZONE은 기본 키에서 사용할 수 있지만 TIMESTAMP WITH TIME ZONE은 사용할 수 없습니다.
RAW 데이터 유형: 이 데이터 유형은 작은 이진 데이터를 저장할 수 있습니다. RAW 데이터가 네트워크에서 시스템 간에 전송되거나 Oracle 유틸리티를 사용하여 한 데이터베이스에 다른 데이터베이스로 이동될 경우 Oracle 서버는 문자 집합 변환을 수행하지 않습니다. 실제 열 값을 저장하는 데 필요한 바이트 수는 각 행마다 크기가 다르며 최대 2,000바이트까지 가능합니다.
LONG, LONG RAW및LOB(Large Object) 데이터 유형
Oracle에서는 LOB을 저장하기 위해 다음 여섯 가지의 데이터 유형을 제공합니다.
• 대형 고정 너비 문자 데이터를 저장하기 위한 CLOB 및 LONG
• 대형 고정 너비 국가별 문자 집합 데이터를 저장하기 위한 NCLOB
• 구조화되지 않은 데이터를 저장하기 위한 BLOB 및 LONG RAW
• 구조화되지 않은 데이터를 운영 체제 파일에 저장하기 위한 BFILE
LONG 및 LONG RAW 데이터 유형은 이전에는 이진 이미지, 문서 또는 지리 정보와 같은 구
조화되지 않은 데이터에 사용되었고 주로 역 호환성을 위해 제공됩니다. 이러한 데이터 유
형은 LOB 데이터 유형으로 교체되었습니다. LOB 데이터 유형은 LONG 및 LONG RAW와 구
분되고 교환할 수 없습니다. LOB은 LONG API(응용 프로그램 프로그래밍 인터페이스)를 지
원하지 않으며 그 반대의 경우도 마찬가지입니다.
이전 유형(LONG 및 LONG RAW)과 비교하면서 LOB 기능을 설명하는 것이 도움이 됩니다.
이후부터 LONG은 LONG과 LONG RAW를, LOB은 모든 LOB 데이터 유형을 가리킵니다.
크기가 VARCHAR2 데이터 유형에 대해 최대 크기(4,000바이트)보다 작지 않으면 LOB에서
는 테이블에 위치자를 테이블 외의 다른 위치에 데이터를 저장하지만 LONG에서는 모든
데이터를 순서대로 저장합니다. 또한 LOB에서는 데이터를 별도의 세그먼트 및 테이블스
페이스 또는 호스트 파일에 저장할 수 있습니다.
LOB에서는 NCLOB을 제외하고 객체 유형 속성과 복제를 지원하지만 LONG에서는 지원하
지 않습니다.
LONG은 기본적으로 다른 블록에 저장된 다음 행 조각을 가리키는 다른 블록의 행 조각과
함께 체인화된 행 조각으로 저장됩니다. 따라서 LONG은 순차적으로 액세스되어야 합니다.
반면 LOB에서는 파일 형식 인터페이스를 통해 데이터에 대한 임의의 조각 방식 액세스를
지원합니다.
ROWID 및UROWID 데이터유형
ROWID는 테이블의 다른 열과 함께 질의할 수 있는 데이터 유형이며 다음 특성을 가집니다.
• ROWID는 데이터베이스에 있는 각 행에 대한 고유 식별자입니다.
• ROWID는 명시적으로 열 값으로서 저장되지 않습니다.
• ROWID는 행의 물리적 주소를 직접 부여하지는 않지만 행 위치를 지정하는 데 사용될 수 있습니다.
• ROWID를 사용하면 가장 빨리 테이블의 행을 액세스할 수 있습니다.
• ROWID는 주어진 키 값의 집합을 가진 행을 지정하기 위해 인덱스에 저장됩니다.
Oracle8.1에서 Oracle 서버는 범용 ROWID 또는 UROWID라고 하는 단일 데이터 유형을 제공하여 Oracle 테이블이 아닌 외래 테이블의 ROWID를 지원하고 모든 종류의 ROWID를 저장 할 수 있습니다. 예를 들어, UROWID 데이터 유형은 IOT(인덱스 구성 테이블)에 저장된 행에 대해 ROWID를 저장하는 데 필요합니다. UROWID를 사용하려면 COMPATIBLE 매개변수의 값을 Oracle8.1 이상으로 설정해야 합니다.
모음데이터유형
테이블의 주어진 행에 대해 반복적인 데이터를 저장할 수 있는 두 가지 모음 데이터 유형이 있습니다. Oracle8i 전의 Oracle 버전에서는 모음을 정의하고 사용하려면 Object 옵션이 필
요했습니다. 이러한 유형에 대한 간략한 설명은 다음과 같습니다.
VARRAY(가변 배열): 가변 배열은 고객 전화 번호와 같은 작은 수의 요소를 포함하고 있는
목록을 저장하는 데 유용합니다.
VARRAY에는 다음 특성이 있습니다.
• 배열은 순서를 지정한 데이터 요소 집합입니다.
• 주어진 배열의 모든 요소는 동일한 데이터 유형입니다.
• 각 요소에는 인덱스가 있으며 이 인덱스는 배열 요소의 위치에 대응하는 번호입니다.
• 배열 요소의 수는 배열의 크기를 결정합니다.
• Oracle 서버에서는 배열이 가변 크기가 될 수 있으므로 VARRAY라고 하지만 최대 크기는 배열 유형 선언 시 지정되어야 합니다.
중첩 테이블: 중첩 데이블을 사용하면 테이블을 테이블 내의 한 열로 정의할 수 있습니다.
중첩 테이블은 주문의 여러 항목처럼 많은 레코드를 가진 집합을 저장하는 데 사용될 수 있
습니다.
중첩 테이블에는 대개 다음 특성이 있습니다.
• 중첩 테이블은 순서를 지정하지 않은 레코드나 행의 집합입니다.
• 중첩 테이블의 행은 동일한 구조를 갖습니다.
• 중첩 테이블의 행은 상위 테이블에 있는 해당 행의 포인터와 함께 상위 테이블과는
별도로 저장됩니다.
• 중첩 테이블의 저장 영역 특성은 데이터베이스 관리자가 정의할 수 있습니다.
• 중첩 테이블에 대해 미리 정의된 최대 크기는 없습니다.
REF(관계데이터유형)
관계 유형은 데이터베이스 내에서 포인터로 사용되며 이러한 유형을 사용하려면 Object 옵션이 필요합니다. 예를 들어, 주문된 각 항목은 제품 코드를 저장하지 않고도 PRODUCTS 테이블의 행을 가리키거나 참조할 수 있습니다.
Oracle 사용자정의데이터유형:
Oracle 서버에서는 사용자가 추상 데이터 유형을 정의하여 응용 프로그램 내에서 사용할
수 있습니다.
ROWID 형식
확장된 ROWID는 디스크에 10 바이트의 저장 영역이 필요하며 18문자를 사용하여 표시됩
니다. ROWID는 다음 요소로 구성됩니다.
• 데이터 객체 번호: 테이블이나 인덱스와 같은 각 데이터 객체가 생성될 때 지정되고 데이터베이스 내에서 고유합니다.
• 상대 파일 번호: 테이블스페이스 내의 각 파일에서 고유합니다.
• 블록 번호: 파일 내의 행을 포함하는 블록의 위치를 나타냅니다.
• 행 번호: 블록 헤더에 있는 행 디렉토리 슬롯의 위치를 식별합니다.
내부적으로 데이터 객체 번호에는 32비트, 상대 파일 번호에는 10비트, 블록 번호에는 22비
트, 행 번호에는 16비트가 필요하며 모두 합하여 총 80비트 또는 10바이트입니다.
확장된 ROWID는 데이터 객체 번호에 여섯 자리, 상대 파일 번호에 세 자리, 블록 번호에 여
섯 자리, 행 번호에 세 자리를 사용하는 기본 64 암호화 체계를 사용하여 표시됩니다. 기본
64 암호화 체계는 아래의 예에서처럼 A-Z, a-z, 0-9, / 등 총 64문자를 사용합니다.
SQL> SELECT department_id, rowid FROM hr.departments;
DEPARTMENT_ID ROWID
------------- ------------------
10 AAABQMAAFAAAAA6AAA
20 AAABQMAAFAAAAA6AAB
30 AAABQMAAFAAAAA6AAC
40 AAABQMAAFAAAAA6AAD
50 AAABQMAAFAAAAA6AAE
60 AAABQMAAFAAAAA6AAF
…
이 예에 대한 설명은 다음과 같습니다.
• AAABQM는 데이터 객체 번호입니다.
• AAF는 상대 파일 번호입니다.
• AAAAA6는 블록 번호입니다.
• AAA는 ID=10인 부서에 대한 행 번호입니다.
Oracle7과 그 이전 버전의 제한된ROWID
Oracle8 이전의 오라클 데이터베이스 버전에서는 제한된 ROWID 형식을 사용했습니다. 제
한된 ROWID는 내부적으로 여섯 바이트만을 사용했고 데이터 객체 번호를 포함하지 않았
습니다. 이러한 형식은 파일 번호가 데이터베이스 내에서 고유하므로 Oracle7 이전 버전에
서 승인되었습니다. 따라서 이전 버전에서는 1,022개를 넘는 데이터 파일을 허용하지 않았
지만 이번 버전에서는 테이블스페이스에 대한 제한입니다.
Oracle8에서는 테이블스페이스 상대 파일 번호를 사용하여 이러한 제한을 제거했지만 제
한된 ROWID는 모든 인덱스 항목이 동일한 세그먼트 내의 행을 참조하는 분할되지 않은 테
이블의 분할되지 않은 인덱스와 같은 객체에서 여전히 사용됩니다.
ROWID를사용한행위치지정
세그먼트는 데이터 객체 번호를 사용하여 테이블스페이스 하나에만 상주할 수 있으므로
Oracle 서버에서는 행을 포함한 테이블스페이스를 결정할 수 있습니다.
테이블스페이스 내의 상대 파일 번호는 파일의 위치, 블록 번호는 행을 포함한 블록의 위치,
행 번호는 행에 대한 행 디렉토리 항목의 위치를 지정하는 데 사용됩니다.
행 디렉토리 항목은 행의 시작 위치를 지정하는 데 사용될 수 있습니다.
따라서 ROWID는 데이터베이스 내의 행 위치를 지정하는 데 사용될 수 있습니다.
행의 구조
행 데이터는 가변 길이 레코드로 데이터베이스 블록에 저장됩니다. 행에 대한 열은 대개 정
의된 순서대로 저장되며 후행 NULL 열은 저장되지 않습니다.• 행 헤더: 행의 열 개수, 체인 정보, 행 잠금 상태를 저장하는 데 사용됩니다.
• 행 데이터: Oracle 서버에서는 각 열에 대해 열 길이와 값을 저장합니다. 열에 250바이
트를 초과하는 저장 영역이 필요한 경우 열 길이를 저장하는 데에는 한 바이트가 필
요합니다. 이 때 세 바이트가 열 길이를 위해 사용됩니다. 열 값은 열 길이 바이트 바
로 다음에 저장됩니다.
인접한 행 간에는 공백이 필요하지 않습니다. 블록의 각 행에는 행 디렉토리에 슬롯이 있으
며 디렉토리 슬롯은 행의 처음을 가리킵니다.
테이블 생성
CREATE TABLE 명령은 관계형 테이블 또는 객체 테이블을 생성하는 데 사용됩니다.
관계형 테이블: 이 테이블은 사용자 데이터를 유지하는 기본 구조입니다.
객체 테이블: 열 정의에 객체 유형을 사용하는 테이블입니다. 객체 테이블은 특정 유형의
객체 인스턴스를 저장하기 위해 명시적으로 정의되는 테이블입니다.
테이블생성지침
• 테이블을 별도의 테이블스페이스에 둡니다.
• 단편화를 방지하려면 지역적으로 관리되는 테이블스페이스를 사용합니다.
다음 예제는 데이터 딕셔너리 관리 테이블스페이스에서 DEPARTMENTS 테이블을 생성합
니다.
SQL> CREATE TABLE hr.departments(
2 department_id NUMBER(4),
3 department_name VARCHAR2(30),
4 manager_id NUMBER(6),
5 location_id NUMBER(4))
6 STORAGE(INITIAL 200K NEXT 200K
7 PCTINCREASE 0 MINEXTENTS 1 MAXEXTENTS 5)
8 TABLESPACE data;
위 구문은 CREATE TABLE 절의 일부입니다.
STORAGE 절
STORAGE 절은 테이블에 대해 저장 영역 특성을 지정합니다. 첫번째 확장 영역에 할당된 저장 영역은 200KB입니다. 두번째 확장 영역이 필요한 경우 NEXT 값으로 정의된 200KB의
저장 영역이 생성됩니다. 세번째 확장 영역이 필요한 경우에는 PCTINCREASE가 0으로 설
정되었으므로 200KB의 저장 영역이 생성됩니다. 사용 가능한 확장 영역 수의 최대값은 5이
고 최소값은 1로 설정됩니다.
• MINEXTENTS: 할당되는 확장 영역의 최소 개수입니다.
• MAXEXTENTS: 할당되는 확장 영역의 최대 개수입니다. MINEXTENTS가 1보다 큰 값
으로 지정되고 테이블스페이스에 데이터 파일이 두 개 이상 포함되면 확장 영역이 다
른 데이터 파일로 분산됩니다.
• PCTINCREASE: NEXT 확장 영역 이후 확장 영역 크기의 증가율입니다.
테이블에 대해 physical_attributes_clause에서 블록 활용 매개변수를 지정할 수 도 있습니다.
• PCTFREE: 테이블의 각 데이터 블록에 있는 공간의 비율을 지정합니다. PCTFREE의 값은 0에서 99까지 설정할 수 있습니다. 0으로 설정하면 전체 블록이 새 행을 삽입하여 채워질 수 있다는 것을 의미합니다. 기본값인 10으로 설정하면 기존 행을 갱신하기 위해 각 블록의 10%를 예약하고 새 행을 삽입하여 각 블록을 최대 90%까지 채울 수 있습니다.
• PCTUSED: 테이블의 각 데이터 블록을 유지 관리하기 위해 사용되는 공간의 최소 비율을 지정합니다. 사용된 공간이 PCTUSED보다 작아지면 행 삽입을 위해 블록이 사용됩니다. PCTUSED는 0에서 99까지 정수로 지정되며 기본값은 40입니다.
PCTFREE와 PCTUSED를 함께 사용하여 새 행이 기존 데이터 블록에 삽입될지 새 블록에 삽입될지 여부를 결정합니다. 이 두 값의 합은 100이하가 되어야 합니다. 이러한 매개변수는 테이블의 공간을 보다 효과적으로 활용하는 데 사용됩니다.
• INITRANS: 테이블에 할당된 각 데이터 블록 내의 초기 할당 트랜잭션 항목 수를 지정합니다. 이 값은 1에서 255까지이며 기본값은 1입니다. 최소 개수의 동시 트랜잭션으로 블록을 갱신할 수 있어야 합니다. 일반적으로 기본값을 변경하지 말아야 합니다.
• MAXTRANS: 테이블에 할당된 데이터 블록을 갱신할 수 있는 동시 트랜잭션의 최대 개수를 지정합니다. 이 제한은 질의에는 적용되지 않습니다. 이 값은 1에서 255까지이며 기본값은 데이터 블록 크기에 따라 달라집니다.
TABLESPACE 절
TABLESPACE 절은 테이블이 생성되는 테이블스페이스를 지정합니다. 예제에 있는 테이블
은 데이터 테이블스페이스 내에 상주합니다. TABLESPACE를 생략한 경우 Oracle은 테이블
을 포함하는 스키마 소유자의 기본 테이블스페이스에 객체를 생성합니다.
테이블 생성 : 지침
실행 취소 세그먼트, 임시 세그먼트 및 인덱스를 포함하는 테이블스페이스가 아닌 별도의 테이블스페이스에 테이블을 둡니다.
단편화를 방지하려면 지역적으로 관리되는 테이블스페이스에 테이블을 넣으십시오.
임시 테이블 생성
임시 테이블을 생성하여 트랜잭션 또는 세션 동안에만 존재하는 세션 전용 데이터를 보유
할 수 있습니다.
CREATE GLOBAL TEMPORARY TABLE 명령은 트랜잭션별 또는 세션별로 임시 테이블을 생성합니다. 세션별 임시 테이블의 경우에는 데이터가 해당 세션 동안에 존재하지만 트랜잭션별 임시 테이블의 경우에는 데이터가 트랜잭션 동안에 존재합니다. 세션의 데이터는 세션 전용이며 각 세션은 자체 데이터만을 보고 수정할 수 있습니다. DML 잠금은 임시 테이블의 데이터에는 적용되지 않습니다. 행의 기간을 제어하는 절은 다음과 같습니다.
• ON COMMIT DELETE ROWS: 트랜잭션 내에서만 행을 볼 수 있도록 지정합니다.
• ON COMMIT PRESERVE ROWS: 전체 세션에서 행을 볼 수 있도록 지정합니다.
임시 테이블에 인덱스, 뷰 및 트리거를 생성하고 또한 Export 유틸리티와 Import 유틸리티를 사용하여 임시 테이블 정의를 엑스포트하고 임포트할 수 있습니다. 그러나 ROWS 옵션을 사용하더라도 데이터는 엑스포트되지 않습니다. 임시 테이블의 정의는 모든 세션에서 볼 수 있습니다.
PCTFREE 및 PCTUSED 설정
PCTFREE 설정
PCTFREE가 높을수록 데이터베이스 블록 내에 갱신할 수 있는 여유 공간이 많아집니다. 테
이블에 다음이 포함되어 있을 경우 높은 값을 설정합니다.
• 처음에는 NULL이고 이후에 값을 가진 열로 갱신되는 열
• 갱신 결과 크기가 증가할 가능성이 있는 열
PCTFREE가 높을수록 블록 밀도가 낮아져서 각 블록은 적은 행을 수용할 수 있습니다.
위에서 지정한 공식은 행 성장에 대비하여 블록에 사용 가능 영역이 충분한지 확인합니다.
PCTUSED 설정
PCTUSED를 설정하여 평균 행을 수용할 만큼 충분한 공간이 있을 때만 사용 가능 영역 목
록에 블록을 반환함을 확인합니다. 사용 가능 영역 목록의 블록에 행을 삽입하기 위한 충분
한 공간이 없을 경우 Oracle 서버에서는 사용 가능 영역 목록의 다음 블록을 조회합니다. 이
러한 선형 스캔은 공간이 충분한 블록을 찾을 때까지 또는 목록의 끝에 도달할 때까지 계속
됩니다. 주어진 공식을 사용하면 필수의 사용 가능 영역이 있는 블록을 찾을 가능성이 높아
져 스캔 시간이 줄어듭니다.
-----------------------------------------------------------------------------------------------------------------
실습
List partition table 생성과 관리
>명령어
SELECT TABLE_OWNER, TABLE_NAME, PARTITION_NAME, HIGH_VALUE, TABLESPACE_NAME
FROM DBA_TAB_PARTITIONS;
- 테이블의 파티션을 조회함
- HIGH_VALUE : 리스트 파티션에서는 일치하는 값, 범위 파티션에서는 상한 값을 나타냄
SELECT OWNER, NAME, COLUMN_NAME
FROM DBA_PART_KEY_COLUMNS;
- 파티션의 기준이 되는 column을 조회
CREATE TABLE
(
..................
)
PARTITION BY LIST (
(
PARTITION
PARTITION
............
);
- Partition으로 구현된 table을 생성
- LIST 절에 collumn명은 여러 개 지정 할 수 없음.
ALTER TABLE
ADD PARTITION
- table에 partition을 추가
ALTER TABLE
DROP PARTITION
- Partition을 삭제
SELECT tablespace_name, bytes, file_name FROM dba_data_files;
2015년 3월 23일 월요일
오라클의 개념_13
ㅇ ㅂㅇ
인덱스 관리
인덱스 분류
인덱스는 테이블에 있는 행을 직접 액세스할 수 있는 트리 구조로서 논리적 설계 또는 물리적 구현에 근거하여 분류할 수 있습니다. 논리적 분류는 인덱스를 응용 프로그램 관점에서 나눈 것이고 물리적 분류는 인덱스 저장 방법에 따라 나눈 것입니다.
단일열인덱스및연결된인덱스
단일 열 인덱스는 해당 인덱스 키에 열이 하나만 있는데 예를 들면, 사원 테이블의 사원 번
호 열에 대한 인덱스가 여기에 해당됩니다.
연결된 인덱스는 조합 인덱스라고도 하며 테이블의 여러 열에 대해 생성되는데 이 열은 테
이블의 열과 순서가 동일하거나 인접할 필요가 없습니다. 예를 들어, 사원 테이블의 부서
열과 직위 열에 대한 인덱스가 여기에 해당됩니다.
조합 키 인덱스의 최대 열 수는 32개지만 모든 열을 합친 크기가 데이터 블록에 있는 사용
가능한 데이터 공간의 2분의 1에서 일부 오버헤드를 뺀 값을 넘지 않아야 합니다.
고유및비고유인덱스
인덱스는 고유 또는 비고유 인덱스일 수 있습니다. 고유 인덱스는 테이블의 두 행 값이 키
열 또는 열에서 중복되지 않도록 합니다. 그러나 비고유 인덱스에서는 열 값에 이러한 제한
을 두지 않습니다.
함수기반인덱스
함수 기반 인덱스는 인덱스화된 테이블의 열을 하나 이상 포함하는 함수 또는 표현식을 사
용할 때 생성되며 함수 또는 표현식의 값을 미리 계산한 다음 인덱스에 저장합니다. 함수
기반 인덱스는 B 트리 인덱스 또는 비트맵 인덱스로 생성할 수 있습니다.
도메인인덱스
도메인 인덱스는 인덱스 유형에 따라 제공되는 루틴에 의해 생성, 관리, 액세스되는 응용
프로그램별(텍스트, 공간) 인덱스입니다. 이 인덱스는 응용 프로그램별 도메인에서 데이터
를 인덱스화하므로 도메인 인덱스라고 합니다.
단일 열 도메인 인덱스만 지원됩니다. 데이터 유형이 스칼라, 객체 또는 LOB인 열에 단일
열 도메인 인덱스를 생성할 수 있습니다.
분할된인덱스및분할되지않은인덱스
분할된 인덱스는 큰 테이블에서 하나의 인덱스에 해당하는 인덱스 항목을 여러 세그먼트
에 저장하는 데 사용하며 이렇게 분할하면 하나의 인덱스를 여러 테이블스페이스에 분산
시켜 인덱스 조회 경합을 줄이고 관리를 용이하게 할 수 있습니다. 분할된 인덱스는 대개
확장성 및 관리 용이성을 향상시키기 위해 분할된 테이블과 함께 사용하는데 각 테이블 분
할 영역마다 하나씩 인덱스 분할 영역을 생성할 수 있습니다.
B 트리 인덱스
모든 인덱스가 B 트리 구조를 사용하고 있지만 B 트리 인덱스라는 용어는 대개 각 키에 대
한 ROWIDS 목록을 저장하는 인덱스와 연관됩니다.
B 트리인덱스구조
인덱스의 맨 위에는 루트가 있으며 루트는 인덱스의 다음 레벨을 가리키는 항목을 포함하
고 다음 레벨에는 분기 블록이 있으며 이 블록은 인덱스의 다음 레벨에 있는 블록을 차례로
가리키며 마지막으로 최하위 레벨에는 최하위 노드가 있고 이 노드는 테이블의 행을 가리
키는 인덱스 항목을 포함합니다. 키 값의 내림차순뿐만 아니라 오름차순으로도 인덱스를
쉽게 스캔할 수 있게 최하위 블록은 이중으로 연결합니다.
인덱스최하위항목형식
인덱스 항목은 다음 구성 요소로 이루어집니다.
• 항목 헤더는 열 수 및 잠금 정보를 저장합니다.
• 키 열의 길이 및 값 쌍은 키 열의 크기 및 열의 값을 정의합니다. (이러한 쌍의 수는 인
덱스에 있는 최대 열 수와 동일합니다.)
• 행의 ROWID는 키 값을 포함합니다.
인덱스최하위항목특성
분할되지 않은 테이블의 B 트리 인덱스:
• 인덱스가 압축되지 않은 경우 여러 행이 동일한 키 값을 갖고 있을 때는 키 값이 반복됩니다.
• 모든 키 열의 값이 NULL인 행에 해당하는 인덱스 항목은 없습니다. 따라서 NULL을 지정하는 WHERE 절은 항상 전체 테이블 스캔을 수행합니다.
• 모든 행이 동일한 세그먼트에 속해 있기 때문에 제한된 ROWID를 사용하여 테이블의 행을 가리킵니다.
인덱스에대한DML 작업효과:
테이블에서 DML 작업을 수행할 경우에는 Oracle 서버가 모든 인덱스를 유지 관리하며 다
음은 인덱스에 대한 DML 명령 효과에 관한 설명입니다.
• 삽입 작업을 수행하면 하나의 인덱스 항목이 해당 블록에 삽입됩니다.
• 행을 삭제하면 해당 인덱스 항목이 논리적으로만 삭제되며 삭제된 행에서 사용하던 공간은 해당 블록의 모든 항목을 삭제할 때까지 새 항목용으로 사용할 수 없습니다.
• 키 열을 갱신하면 논리적으로 삭제되고 인덱스에 삽입되는데 PCTFREE 설정은 생성 시를 제외하고는 인덱스에 영향을 미치지 않으므로 PCTFREE에서 지정한 것보다 공간이 적더라도 새 항목을 인덱스 블록에 추가할 수 있습니다.
비트맵 인덱스
다음 상황에서는 비트맵 인덱스가 B 트리 인덱스보다 유리합니다.
• 테이블에 수 백만 개의 행이 있고 키 열에 낮은 기수가 있을 때, 즉 해당 열의 구분 값이 극소수일 경우. 예를 들어, 여권 레코드를 포함하는 테이블의 성별 및 결혼 여부 열에서는 B 트리 인덱스보다 비트맵 인덱스를 선호할 수 있습니다.
• 질의가 OR 연산자를 포함하는 여러 WHERE 조건을 조합하여 사용할 경우
• 읽기 전용 또는 키 열에 대한 갱신 작업이 저조할 경우
비트맵인덱스구조
비트맵 인덱스도 B 트리와 같이 구성하지만 최하위 노드는 ROWIDS 목록 대신 각 키 값에
대한 비트맵을 저장합니다. 비트맵 내의 각 비트는 가능한 ROWID와 대응하며 비트가 설정
되어 있으면 해당 ROWID가 있는 행이 키 값을 포함하고 있음을 의미합니다.
도표와 같이 비트맵 인덱스의 최하위 노드는 다음 내용을 포함합니다.
• 항목 헤더, 열 수 및 잠금 정보를 포함합니다.
• 각 키 열의 길이 및 값 쌍으로 이루어진 키 값(예제에서 키는 단 하나의 열로 구성되어 있고 첫째 항목의 키 값은 Blue입니다.)
• 시작 ROWID, 예제에서는 파일 번호 3, 블록 번호 10, 행 번호 0 등을 포함하고 있습니다.
• 끝 ROWID, 예제에서는 블록 번호 12 및 행 번호 8을 포함합니다.
• 비트 문자열로 이루어진 비트맵 세그먼트(비트는 해당 행이 키 값을 포함하고 있을 때 설정하고 해당 행이 키 값을 포함하고 있지 않을 때는 설정을 해제하며 Oracle 서버는 고유 압축 기술을 사용하여 비트맵 세그먼트를 저장합니다.)
시작 ROWID는 비트맵의 비트맵 세그먼트가 가리키는 첫번째 행의 ROWID이며 비트맵의
첫번째 비트는 첫번째 ROWID에 해당하고 비트맵의 두번째 비트는 블록의 다음 행에 해당
하며 마지막 ROWID는 비트맵 세그먼트에 포함된 테이블의 마지막 행에 대한 포인터입니
다. 비트맵 인덱스는 제한된 ROWID를 사용합니다.
비트맵인덱스사용
B 트리는 주어진 키 값의 비트맵 세그먼트를 포함하는 최하위 노드를 찾는 데 사용하며 시
작 ROWID 및 비트맵 세그먼트를 사용하여 사용 키 값을 포함하는 행을 찾습니다.
테이블의 키 열을 변경하면 비트맵을 수정해야 하며 관련 비트맵 세그먼트는 잠급니
다. 전체 비트맵 세그먼트를 잠가야 하므로 첫번째 트랜잭션이 끝날 때까지는 해당 비트맵
에 포함된 행을 다른 트랜잭션에서 갱신할 수 없습니다.
> 비트맵에서 0,1로 이루어진 수들은 테이블의 행의 수와 동일함, 테이블에 행을 추가 할 시 모든 키의 비트맵이 하나씩 늘어 나므로 insert 하는 트랜잭션 하나만 제외하고 모든 사용자는 사용 불가(lock 상태 이므로)
B트리인덱스와 비트맵 인덱스 비교
낮은 기수 열과 함께 사용할 때는 비트맵 인덱스가 B 트리 인덱스보다 크기가 작습니다.
비트맵 인덱스는 비트맵 세그먼트 수준의 잠금을 사용하기 때문에 비트맵 인덱스의 키 열을 갱신하면 더 많은 비용이 들지만 B 트리 인덱스에서는 테이블의 각 행에 해당하는 항목을 잠급니다.
비트맵 인덱스는 비트맵 부울 같은 연산을 수행하는 데 사용할 수 있으며 Oracle 서버는 두
비트맵 세그먼트를 사용하여 비트 방식 부울 연산을 수행하고 결과 비트맵을 얻을 수 있으며 부울 술어를 사용하는 질의에서 비트맵을 효과적으로 사용할 수 있습니다.
요약하면 동적 테이블을 인덱스하기 위한 OLTP
환경에서는 B 트리 인덱스가 더 적합하고
대형 정적 테이블에서 복합 질의를 사용하는 데이터 웨어하우스 환경에서는 비트맵 인덱스
가 더 적합합니다.
일반 B 트리 인덱스 생성
인덱스는 해당 테이블을 소유하는 사용자의 계정 또는 다른 계정에서 생성할 수 있으며 일
반적으로 테이블과 동일한 계정에서 생성합니다.
위의 명령문은 LAST_NAME 열을 사용하여 EMPLOYEES 테이블에 인덱스를 생성합니다.
구문옵션
UNIQUE: 고유 인덱스 지정에 사용합니다 기본값은 Nonunique입니다.)
Schema: 인덱스/테이블 소유자입니다.
Index: 인덱스 이름입니다.
Table: 테이블 이름입니다
Column: 열 이름입니다.
ASC/DESC: 인덱스가 오름차순으로 생성되는지 내림차순으로 생성되는지 여부를 나타냅니다.
TABLESPACE: 인덱스를 생성할 테이블스페이스를 식별합니다.
PCTFREE: 새로운 인덱스 항목을 수용하기 위해 생성 시 각 블록에 예약되는 공간의 양(전체 공간에서 블록 헤더를 뺀 백분율)입니다.
INITRANS: 각 블록에서 미리 할당하는 트랜잭션 항목의 수를 나타냅니다 . (기본값과 최소값은 2입니다.)
MAXTRANS: 각 블록에 할당될 수 있는 트랜잭션 항목의 수를 제한합니다. (기본값은 255입니다.)
STORAGE 절: 인덱스에 확장 영역 할당하는 방법을 결정하는 저장 영역 절을 식별합니다.
LOGGING: 인덱스의 생성 및 인덱스에 대한 이후 작업을 리두 로그 파일에 기록함을 나타냅니다. (기본값입니다.)
NOLOGGING: 생성 및 특정 유형의 데이터 로드를 리두 로그 파일에 기록하지 않음을 나타냅니다.
NOSORT: 데이터베이스에 행이 오름차순으로 저장되므로 인덱스 생성 시 Oracle 서버가 행을 정렬하지 않아도 됨을 나타냅니다.
> PCTFREE 용량을 현재는 지정하지 않는 이유는 segment space management 가 auto이기 때문
> STORAGE 용량을 현재 설정하지 않는 이유는 local management가 auto이기 때문
인덱스 생성 : 지침
인덱스 생성 시 다음 사항을 고려합니다.
• 인덱스를 사용하면 질의 성능 속도는 빨라지지만 DML 작업 속도는 느려지며 휘발성 테이블에 필요한 인덱스 수는 항상 최소화합니다.
• 실행 취소 세그먼트, 임시 세그먼트 및 테이블을 포함하는 테이블스페이스가 아닌 별도의 테이블스페이스에 인덱스를 둡니다.
• 큰 인덱스의 경우 리두 생성을 방지하면 성능을 상당히 향상시킬 수 있으므로 큰 인덱스를 생성할 경우에는 NOLOGGING 절을 사용하는 것이 좋습니다.
• 인덱스 항목은 자신이 인덱스하는 행보다 작기 때문에 인덱스 블록은 블록마다 많은 항목을 포함하며 일반적으로 해당 테이블보다 인덱스에 대한 INITRANS가 더 높아야 합니다.
인덱스및 PCTFREE:
인덱스에 대한 PCTFREE 매개변수는 테이블의 PCTFREE 매개변수와 다릅니다. 즉, 이 매개변수는 동일한 인덱스 블록에 삽입할 인덱스 항목의 공간을 예약하기 위해 인덱스 생성시에만 사용합니다. 인덱스 항목은 갱신되지 않으며 키 열이 갱신될 때 인덱스 항목의 논리적 삭제 및 삽입이 발생합니다.
시스템이 생성한 송장 번호와 같이 차례대로 증가하는 열의 인덱스에는 낮은 PCTFREE를 사용합니다. 이러한 경우에는 항상 새로운 인덱스를 기존 인덱스 뒤에 추가하므로 새 항목을 기존의 두 인덱스 항목 사이에 삽입할 필요가 없습니다.
삽입하는 행의 인덱스화된 열 값이 임의의 값, 즉 현재 값의 범위에 포함되는 값일 수 있는 경우에는 높은 PCTFREE를 제공해야 합니다. 높은 PCTFREE를 필요로 하는 인덱스의 예로 송장 테이블의 고객 코드 열에 대한 인덱스를 들 수 있는데 이러한 경우에는 다음 공식에서구한 값으로 PCTFREE의 값을 지정하는 것이 좋습니다.
Maximum number of rows – Initial number of rows x 100
------------------------------------------------------------------
Maximum number of rows
최대값은 1년과 같은 특정 기간을 참조할 수 있습니다.
> 보통 전체 데이터의 10% 만을 사용(but 화면에 200~300개 출력해 쓰는 것을 권장)
> 몇 만개 단위시 index를 쓰지 않음.
> index size < table size
비트맵 인덱스 생성
구문
다음 명령을 사용하여 비트맵 인덱스를 생성합니다.
CREATE BITMAP INDEX [schema.] index
ON [schema.] table
(column [ ASC | DESC ] [ , column [ASC | DESC ] ] ...)
[ TABLESPACE tablespace ]
[ PCTFREE integer ]
[ INITRANS integer ]
[ MAXTRANS integer ]
[ storage-clause ]
[ LOGGING| NOLOGGING ]
[ NOSORT ]
비트맵 인덱스는 고유할 수 없습니다.
CREATE_BITMAP_AREA_SIZE매개변수
초기화 매개변수인 CREATE_BITMAP_AREA_SIZE는 비트맵 세그먼트를 메모리에 저장하
는 데 사용하는 공간의 양을 결정하며 기본값은 8MB입니다. 값이 클수록 인덱스를 빨리 생
성할 수 있고 기수가 아주 작은 경우에는 이 값을 작은 값으로 설정할 수 있습니다. 예를 들
어, 기수가 겨우 2이면 값을 MB가 아닌 KB 순서로 나열하며 일반적으로 기수가 높은 경우
에는 메모리가 충분해야 최적의 성능을 낼 수 있습니다.
인덱스 저장 영역 매개변수 변경
일부 저장 영역 매개변수 및 블록 활용 매개변수는 ALTER INDEX 명령을 사용하여 수정합니다.
구문
ALTER INDEX [schema.]index
[ storage-clause ]
[ INITRANS integer ]
[ MAXTRANS integer ]
인덱스 저장 영역 매개변수를 변경한 결과는 테이블 저장 영역 매개변수를 변경한 결과와동일하며 이러한 변경은 주로 인덱스의 MAXEXTENTS를 늘리는 데 사용합니다.
인덱스 블록의 동시성 레벨을 높이기 위해 블록 활용 매개변수를 변경하는 경우도 있습니다.
> 위 구문은 Local management 가 auto 이기 때문에 storage를 설정 해주지 않음
인덱스 공간 할당 및 할당 해제
인덱스에수동으로공간할당:
테이블에 대한 대량의 삽입 작업 기간 전에 인덱스에 확장 영역을 추가해야 할 수 있으며
확장 영역을 추가하면 인덱스가 동적으로 확장되어 성능 저하를 방지할 수 있습니다.
인덱스에서수동으로공간할당해제
ALTER INDEX 명령의 DEALLOCATE 절을 사용하여 인덱스에서 고수위 이상의 사용되지 않은 공간을 해제합니다.
구문
다음 명령을 사용하여 인덱스 공간을 할당하거나 할당을 해제합니다.
ALTER INDEX [schema.]index
{ALLOCATE EXTENT ([SIZE integer [K|M]]
[ DATAFILE ‘filename’ ])
| DEALLOCATE UNUSED [KEEP integer [ K|M ] ] }
수동의 인덱스 공간 할당 작업 및 수동의 할당 해제 작업은 테이블에서 이 명령을 사용할
경우와 동일한 규칙을 따릅니다.
인덱스 재구축
인덱스 재구축에는 다음 특성이 있습니다.
• 기존 인덱스를 데이터 소스로 사용하여 새 인덱스를 구축합니다.
• 기존 인덱스를 사용하여 인덱스를 구축할 경우에는 정렬이 필요하지 않으므로 성능이 향상됩니다.
• 새 인덱스를 구축하고 나면 이전 인덱스는 삭제되며 재구축 중에는 이전 인덱스 및 새 인덱스를 각 테이블스페이스에 모두 수용할 수 있는 충분한 공간이 필요합니다.
• 결과 인덱스는 삭제한 항목을 포함하지 않으므로 이 인덱스는 공간을 더 효율적으로 사용합니다.
• 새 인덱스를 구축하는 동안에는 질의에서 기존 인덱스를 계속 사용할 수 있습니다.
재구축이 필요한 상황
다음 상황일 때 인덱스를 재구축합니다.
• 기존 인덱스를 다른 테이블스페이스로 이동해야 할 경우로 인덱스가 테이블과 동일한 테이블스페이스에 있거나 객체를 디스크에 재분배해야 할 경우에는 이 작업이 필요할 수 있습니다.
• 인덱스에 삭제한 항목이 많이 포함되어 있는 경우로 이러한 현상은 완료된 주문은 삭제하고 새로운 주문을 높은 번호로 테이블에 추가하는 주문 테이블의 주문 번호 인덱스와 같이 변하는 인덱스에서 나타나는 일반적인 문제입니다. 오래된 소수의 주문을아직 처리하지 않은 경우 항목 일부만 삭제한 인덱스 최하위 블록이 몇 개 있을 수도있습니다.
• 기존의 일반 인덱스를 역방향 키 인덱스로 변환해야 할 경우로 이전 릴리스의 Oracle 서버에서 응용 프로그램을 이전할 경우 재구축할 수 있습니다.
• 인덱스의 테이블을 ALTER TABLE ... MOVE TABLESPACE 명령을 사용하여 다른 테이블스페이스로 이동한 경우
구문
다음 명령을 사용하여 인덱스를 재구축합니다.
ALTER INDEX [schema.] index REBUILD
[ TABLESPACE tablespace ]
[ PCTFREE integer ]
[ INITRANS integer ]
[ MAXTRANS integer ]
[ storage-clause ]
[ LOGGING| NOLOGGING ]
[ REVERSE | NOREVERSE ]
ALTER INDEX ... REBUILD 명령은 비트맵 인덱스를 B 트리 인덱스로 바꾸거나 또는 그 반대인 경우 사용할 수 없으며 REVERSE 키워드 또는 NOREVERSE 키워드는 B 트리 인덱스에만 지정할 수 있습니다.
> 테이블의 move와 동일함
온라인으로 인덱스 재구축
인덱스 구축 또는 재구축 작업은 테이블이 아주 큰 경우 시간이 많이 걸리는 작업이며 Oracle8i 이전에는 인덱스를 생성 또는 재구축할 경우 테이블을 잠궈야 했고 동시 DML 작업을 할 수 없었습니다.
Oracle9i는 인덱스를 생성 또는 재생성하면서 기본 테이블에 대한 동시 작업을 수행할 수
있지만 이러한 절차 중에는 큰 DML 작업을 수행하지 않는 것이 좋습니다.
> 계속해서 DML 문이 잠겨 있으면 온라인 인덱스 구축 중에 다른 DDL 작업을 수행할 수 없음을 의미합니다.
제한사항
• 임시 테이블의 인덱스는 재구축할 수 없습니다.
• 분할된 인덱스 전체는 재구축할 수 없으므로 분할 영역 또는 서브 분할 영역을 각각 재구축해야 합니다.
• 사용되지 않은 공간은 할당을 해제할 수 없습니다.
• 해당 인덱스에 대한 PCTFREE 매개변수의 값을 전체적으로 변경할 수 없습니다.
> 대게 온라인 상태로 재구축을 하지 않음.
> 기존 인덱스는 두고 새로운 인덱스는 만드는 것 (원래 방식은 기존 인덱스를 지우고 새로 만드는 방법)
인덱스 병합
인덱스 단편화가 있는 경우 해당 인덱스를 재구축 또는 병합할 수 있으며 이러한 작업을 수행하기 전에 먼저 각 옵션의 비용 및 이익을 고려하여 자신의 상황에 가장 적합한 작업을 선택해야 합니다. 인덱스 병합은 온라인에서 수행되는 블록 재구축입니다.
재사용을 위해 공간을 늘릴 수 있는 B 트리 인덱스 최하위 블록이 있는 상황에서는 다음 SQL 문을 사용하여 이 최하위 블록을 병합할 수 있습니다.
SQL> ALTER INDEX hr.employees_idx COALESCE;
위 그림은 hr.employees_idx 인덱스에 대한 ALTER INDEX ∼ COALESCE의 영향을 보여 주고 있습니다. COALESCE 작업을 수행하기 전 첫번째 두 개의 최하위 블록은 50%가 채워진 상태입니다. 이것은 인덱스가 단편화되었으므로 병합되어 첫번째 블록을 모두 채 울 수 있고 단편화를 줄일 수 있다는 의미입니다.
인덱스 및 유효성 검사
인덱스를 분석하여 다음을 수행합니다.
• 모든 인덱스 블록에 대해 손상된 블록이 있는지 확인합니다. 이 명령을 수행해도 인덱스 항목이 테이블의 데이터에 대응되는지 여부는 확인되지 않습니다.
• INDEX_STATS 뷰를 인덱스 정보로 채웁니다.
구문
ANALYZE INDEX [ schema.]index VALIDATE STRUCTURE
이 명령을 실행한 후 다음 예제에 나타난 대로 INDEX_STATS를 질의하여 인덱스 정보를 얻습니다.
SQL> SELECT blocks, pct_used, distinct_keys
2 lf_rows, del_lf_rows
3 FROM index_stats;
BLOCKS PCT_USED LF_ROWS DEL_LF_ROWS
---------- ----------- ----------- -----------------
25 11 14 0
1 row selected.
인덱스에 삭제된 행의 비율이 높은 경우 해당 인덱스를 재구성합니다. 예를 들어,
DEL_LF_ROWS와 LF_ROWS의 비율이 30%를 초과하는 경우가 이에 해당합니다.
> 특정 Table의 딕셔너리 정보를 갱신 시켜줌
> DDL 명령어 (create, alter, drop, ..) -> 딕셔너리에 바로바로 정보를 갱신
> DML 명령어 (insert, delete, ....) -> 딕셔너리에 정보를 갱신 하지 않음
인덱스 삭제
다음 시나리오에서는 인덱스를 삭제해야 할 필요가 있습니다.
• 응용 프로그램에서 더 이상 사용하지 않는 인덱스는 삭제할 수 있습니다.
• 대량 로드를 수행하기 전에 인덱스를 삭제할 수 있으며 데이터를 대량으로 로드 하기 전에 인덱스를 삭제하고 로드한 다음 다시 생성하면 다음 결과를 얻을 수 있습니다.
– 로드 성능이 향상됩니다.
– 인덱스 공간을 더 효율적으로 사용할 수 있습니다.
• 주기적으로만 사용하는 인덱스가 특히 휘발성 테이블에 기반을 두고 있을 경우에는 불필요하게 유지 관리하지 않아도 되며 대개 연말 또는 분기 말의 검토 회의에 사용할 정보를 모으기 위해 임시 질의를 생성하는 OLTP 시스템의 경우에는불필요하게 유지 관리하지 않아도 됩니다.
• 로드 작업 같은 특정 유형의 작업 중에 인스턴스 실패가 발생하는 경우에는 인덱스를 INVALID로 표시하는데 이러한 경우에는 인덱스를 삭제하고 다시 생성해야 합니다.
• 인덱스가 훼손된 경우
제약 조건에 필요한 인덱스는 삭제할 수 없으므로 종속된 제약 조건을 비활성화하거나 삭
제해야 합니다.
사용되지 않은 인덱스 식별
Oracle9i부터는 인덱스 사용에 대한 통계를 수집하여 V$OBJECT_USAGE에 표시할 수 있습니다. 수집된 정보를 통해 인덱스가 사용되지 않았다는 것이 확인되면 해당 인덱스를 삭제할 수 있습니다. 또한 사용되지 않은 인덱스를 제거하면 Oracle 서버가 DML에 대해 수행해야 하는 오버헤드를 방지할 수 있으므로 성능이 향상됩니다. MONITORING USAGE 절이 지정될 때마다 V$OBJECT_USAGE가 지정된 인덱스에 대해 재설정됩니다. 이전 정보는 지워지거나 재설정되고 새로운 시작 시간이 기록됩니다.
V$OBJECT_USAGE 열
INDEX_NAME: 인덱스 이름입니다.
TABLE_NAME: 해당 테이블입니다.
MONITORING: 모니터를 ON으로 설정할지 OFF로 설정할지 여부를 나타냅니다.
USED: 모니터하는 동안 인덱스가 사용되었는지 여부를 YES 또는 NO로 나타냅니다.
START_MONITORING: 인덱스에 대한 모니터의 시작 시간을 나타냅니다.
END_MONITORING: 인덱스에 대한 모니터의 중지 시간을 나타냅니다.
인덱스 관리
인덱스 분류
인덱스는 테이블에 있는 행을 직접 액세스할 수 있는 트리 구조로서 논리적 설계 또는 물리적 구현에 근거하여 분류할 수 있습니다. 논리적 분류는 인덱스를 응용 프로그램 관점에서 나눈 것이고 물리적 분류는 인덱스 저장 방법에 따라 나눈 것입니다.
단일열인덱스및연결된인덱스
단일 열 인덱스는 해당 인덱스 키에 열이 하나만 있는데 예를 들면, 사원 테이블의 사원 번
호 열에 대한 인덱스가 여기에 해당됩니다.
연결된 인덱스는 조합 인덱스라고도 하며 테이블의 여러 열에 대해 생성되는데 이 열은 테
이블의 열과 순서가 동일하거나 인접할 필요가 없습니다. 예를 들어, 사원 테이블의 부서
열과 직위 열에 대한 인덱스가 여기에 해당됩니다.
조합 키 인덱스의 최대 열 수는 32개지만 모든 열을 합친 크기가 데이터 블록에 있는 사용
가능한 데이터 공간의 2분의 1에서 일부 오버헤드를 뺀 값을 넘지 않아야 합니다.
고유및비고유인덱스
인덱스는 고유 또는 비고유 인덱스일 수 있습니다. 고유 인덱스는 테이블의 두 행 값이 키
열 또는 열에서 중복되지 않도록 합니다. 그러나 비고유 인덱스에서는 열 값에 이러한 제한
을 두지 않습니다.
함수기반인덱스
함수 기반 인덱스는 인덱스화된 테이블의 열을 하나 이상 포함하는 함수 또는 표현식을 사
용할 때 생성되며 함수 또는 표현식의 값을 미리 계산한 다음 인덱스에 저장합니다. 함수
기반 인덱스는 B 트리 인덱스 또는 비트맵 인덱스로 생성할 수 있습니다.
도메인인덱스
도메인 인덱스는 인덱스 유형에 따라 제공되는 루틴에 의해 생성, 관리, 액세스되는 응용
프로그램별(텍스트, 공간) 인덱스입니다. 이 인덱스는 응용 프로그램별 도메인에서 데이터
를 인덱스화하므로 도메인 인덱스라고 합니다.
단일 열 도메인 인덱스만 지원됩니다. 데이터 유형이 스칼라, 객체 또는 LOB인 열에 단일
열 도메인 인덱스를 생성할 수 있습니다.
분할된인덱스및분할되지않은인덱스
분할된 인덱스는 큰 테이블에서 하나의 인덱스에 해당하는 인덱스 항목을 여러 세그먼트
에 저장하는 데 사용하며 이렇게 분할하면 하나의 인덱스를 여러 테이블스페이스에 분산
시켜 인덱스 조회 경합을 줄이고 관리를 용이하게 할 수 있습니다. 분할된 인덱스는 대개
확장성 및 관리 용이성을 향상시키기 위해 분할된 테이블과 함께 사용하는데 각 테이블 분
할 영역마다 하나씩 인덱스 분할 영역을 생성할 수 있습니다.
B 트리 인덱스
모든 인덱스가 B 트리 구조를 사용하고 있지만 B 트리 인덱스라는 용어는 대개 각 키에 대
한 ROWIDS 목록을 저장하는 인덱스와 연관됩니다.
B 트리인덱스구조
인덱스의 맨 위에는 루트가 있으며 루트는 인덱스의 다음 레벨을 가리키는 항목을 포함하
고 다음 레벨에는 분기 블록이 있으며 이 블록은 인덱스의 다음 레벨에 있는 블록을 차례로
가리키며 마지막으로 최하위 레벨에는 최하위 노드가 있고 이 노드는 테이블의 행을 가리
키는 인덱스 항목을 포함합니다. 키 값의 내림차순뿐만 아니라 오름차순으로도 인덱스를
쉽게 스캔할 수 있게 최하위 블록은 이중으로 연결합니다.
인덱스최하위항목형식
인덱스 항목은 다음 구성 요소로 이루어집니다.
• 항목 헤더는 열 수 및 잠금 정보를 저장합니다.
• 키 열의 길이 및 값 쌍은 키 열의 크기 및 열의 값을 정의합니다. (이러한 쌍의 수는 인
덱스에 있는 최대 열 수와 동일합니다.)
• 행의 ROWID는 키 값을 포함합니다.
인덱스최하위항목특성
분할되지 않은 테이블의 B 트리 인덱스:
• 인덱스가 압축되지 않은 경우 여러 행이 동일한 키 값을 갖고 있을 때는 키 값이 반복됩니다.
• 모든 키 열의 값이 NULL인 행에 해당하는 인덱스 항목은 없습니다. 따라서 NULL을 지정하는 WHERE 절은 항상 전체 테이블 스캔을 수행합니다.
• 모든 행이 동일한 세그먼트에 속해 있기 때문에 제한된 ROWID를 사용하여 테이블의 행을 가리킵니다.
인덱스에대한DML 작업효과:
테이블에서 DML 작업을 수행할 경우에는 Oracle 서버가 모든 인덱스를 유지 관리하며 다
음은 인덱스에 대한 DML 명령 효과에 관한 설명입니다.
• 삽입 작업을 수행하면 하나의 인덱스 항목이 해당 블록에 삽입됩니다.
• 행을 삭제하면 해당 인덱스 항목이 논리적으로만 삭제되며 삭제된 행에서 사용하던 공간은 해당 블록의 모든 항목을 삭제할 때까지 새 항목용으로 사용할 수 없습니다.
• 키 열을 갱신하면 논리적으로 삭제되고 인덱스에 삽입되는데 PCTFREE 설정은 생성 시를 제외하고는 인덱스에 영향을 미치지 않으므로 PCTFREE에서 지정한 것보다 공간이 적더라도 새 항목을 인덱스 블록에 추가할 수 있습니다.
B 스타 트리 인덱스의 예제
리버스 키에 대해서
인덱스의 증가에 대해서
> leaf 노드간 붉은 색 화살표는 노드간의 링크를 뜻함 링크는 where절에서 between 조건 시 시작 값이 있는 leaf 노드를 찾고 찾은 leaf 노드의 링크를 통해 끝 값을 마저 찾음 , Leaf 노드에 인덱스가 정렬되어 들어감, Branch, Root에는 노드에 관련된 정보가 들어가 있음
> pin point query : 컬럼 값을 하나씩 모두 조회 하여 찾는 것
ex) where no is (1,2)
> range query : 범위로 값을 모두 조회 하여 찾는 것
ex) where no between 1 and 2
비트맵 인덱스
다음 상황에서는 비트맵 인덱스가 B 트리 인덱스보다 유리합니다.
• 테이블에 수 백만 개의 행이 있고 키 열에 낮은 기수가 있을 때, 즉 해당 열의 구분 값이 극소수일 경우. 예를 들어, 여권 레코드를 포함하는 테이블의 성별 및 결혼 여부 열에서는 B 트리 인덱스보다 비트맵 인덱스를 선호할 수 있습니다.
• 질의가 OR 연산자를 포함하는 여러 WHERE 조건을 조합하여 사용할 경우
• 읽기 전용 또는 키 열에 대한 갱신 작업이 저조할 경우
비트맵인덱스구조
비트맵 인덱스도 B 트리와 같이 구성하지만 최하위 노드는 ROWIDS 목록 대신 각 키 값에
대한 비트맵을 저장합니다. 비트맵 내의 각 비트는 가능한 ROWID와 대응하며 비트가 설정
되어 있으면 해당 ROWID가 있는 행이 키 값을 포함하고 있음을 의미합니다.
도표와 같이 비트맵 인덱스의 최하위 노드는 다음 내용을 포함합니다.
• 항목 헤더, 열 수 및 잠금 정보를 포함합니다.
• 각 키 열의 길이 및 값 쌍으로 이루어진 키 값(예제에서 키는 단 하나의 열로 구성되어 있고 첫째 항목의 키 값은 Blue입니다.)
• 시작 ROWID, 예제에서는 파일 번호 3, 블록 번호 10, 행 번호 0 등을 포함하고 있습니다.
• 끝 ROWID, 예제에서는 블록 번호 12 및 행 번호 8을 포함합니다.
• 비트 문자열로 이루어진 비트맵 세그먼트(비트는 해당 행이 키 값을 포함하고 있을 때 설정하고 해당 행이 키 값을 포함하고 있지 않을 때는 설정을 해제하며 Oracle 서버는 고유 압축 기술을 사용하여 비트맵 세그먼트를 저장합니다.)
시작 ROWID는 비트맵의 비트맵 세그먼트가 가리키는 첫번째 행의 ROWID이며 비트맵의
첫번째 비트는 첫번째 ROWID에 해당하고 비트맵의 두번째 비트는 블록의 다음 행에 해당
하며 마지막 ROWID는 비트맵 세그먼트에 포함된 테이블의 마지막 행에 대한 포인터입니
다. 비트맵 인덱스는 제한된 ROWID를 사용합니다.
비트맵인덱스사용
B 트리는 주어진 키 값의 비트맵 세그먼트를 포함하는 최하위 노드를 찾는 데 사용하며 시
작 ROWID 및 비트맵 세그먼트를 사용하여 사용 키 값을 포함하는 행을 찾습니다.
테이블의 키 열을 변경하면 비트맵을 수정해야 하며 관련 비트맵 세그먼트는 잠급니
다. 전체 비트맵 세그먼트를 잠가야 하므로 첫번째 트랜잭션이 끝날 때까지는 해당 비트맵
에 포함된 행을 다른 트랜잭션에서 갱신할 수 없습니다.
> 비트맵에서 0,1로 이루어진 수들은 테이블의 행의 수와 동일함, 테이블에 행을 추가 할 시 모든 키의 비트맵이 하나씩 늘어 나므로 insert 하는 트랜잭션 하나만 제외하고 모든 사용자는 사용 불가(lock 상태 이므로)
B트리인덱스와 비트맵 인덱스 비교
낮은 기수 열과 함께 사용할 때는 비트맵 인덱스가 B 트리 인덱스보다 크기가 작습니다.
비트맵 인덱스는 비트맵 세그먼트 수준의 잠금을 사용하기 때문에 비트맵 인덱스의 키 열을 갱신하면 더 많은 비용이 들지만 B 트리 인덱스에서는 테이블의 각 행에 해당하는 항목을 잠급니다.
비트맵 인덱스는 비트맵 부울 같은 연산을 수행하는 데 사용할 수 있으며 Oracle 서버는 두
비트맵 세그먼트를 사용하여 비트 방식 부울 연산을 수행하고 결과 비트맵을 얻을 수 있으며 부울 술어를 사용하는 질의에서 비트맵을 효과적으로 사용할 수 있습니다.
요약하면 동적 테이블을 인덱스하기 위한 OLTP
환경에서는 B 트리 인덱스가 더 적합하고
대형 정적 테이블에서 복합 질의를 사용하는 데이터 웨어하우스 환경에서는 비트맵 인덱스
가 더 적합합니다.
일반 B 트리 인덱스 생성
인덱스는 해당 테이블을 소유하는 사용자의 계정 또는 다른 계정에서 생성할 수 있으며 일
반적으로 테이블과 동일한 계정에서 생성합니다.
위의 명령문은 LAST_NAME 열을 사용하여 EMPLOYEES 테이블에 인덱스를 생성합니다.
구문옵션
UNIQUE: 고유 인덱스 지정에 사용합니다 기본값은 Nonunique입니다.)
Schema: 인덱스/테이블 소유자입니다.
Index: 인덱스 이름입니다.
Table: 테이블 이름입니다
Column: 열 이름입니다.
ASC/DESC: 인덱스가 오름차순으로 생성되는지 내림차순으로 생성되는지 여부를 나타냅니다.
TABLESPACE: 인덱스를 생성할 테이블스페이스를 식별합니다.
PCTFREE: 새로운 인덱스 항목을 수용하기 위해 생성 시 각 블록에 예약되는 공간의 양(전체 공간에서 블록 헤더를 뺀 백분율)입니다.
INITRANS: 각 블록에서 미리 할당하는 트랜잭션 항목의 수를 나타냅니다 . (기본값과 최소값은 2입니다.)
MAXTRANS: 각 블록에 할당될 수 있는 트랜잭션 항목의 수를 제한합니다. (기본값은 255입니다.)
STORAGE 절: 인덱스에 확장 영역 할당하는 방법을 결정하는 저장 영역 절을 식별합니다.
LOGGING: 인덱스의 생성 및 인덱스에 대한 이후 작업을 리두 로그 파일에 기록함을 나타냅니다. (기본값입니다.)
NOLOGGING: 생성 및 특정 유형의 데이터 로드를 리두 로그 파일에 기록하지 않음을 나타냅니다.
NOSORT: 데이터베이스에 행이 오름차순으로 저장되므로 인덱스 생성 시 Oracle 서버가 행을 정렬하지 않아도 됨을 나타냅니다.
> PCTFREE 용량을 현재는 지정하지 않는 이유는 segment space management 가 auto이기 때문
> STORAGE 용량을 현재 설정하지 않는 이유는 local management가 auto이기 때문
인덱스 생성 : 지침
인덱스 생성 시 다음 사항을 고려합니다.
• 인덱스를 사용하면 질의 성능 속도는 빨라지지만 DML 작업 속도는 느려지며 휘발성 테이블에 필요한 인덱스 수는 항상 최소화합니다.
• 실행 취소 세그먼트, 임시 세그먼트 및 테이블을 포함하는 테이블스페이스가 아닌 별도의 테이블스페이스에 인덱스를 둡니다.
• 큰 인덱스의 경우 리두 생성을 방지하면 성능을 상당히 향상시킬 수 있으므로 큰 인덱스를 생성할 경우에는 NOLOGGING 절을 사용하는 것이 좋습니다.
• 인덱스 항목은 자신이 인덱스하는 행보다 작기 때문에 인덱스 블록은 블록마다 많은 항목을 포함하며 일반적으로 해당 테이블보다 인덱스에 대한 INITRANS가 더 높아야 합니다.
인덱스및 PCTFREE:
인덱스에 대한 PCTFREE 매개변수는 테이블의 PCTFREE 매개변수와 다릅니다. 즉, 이 매개변수는 동일한 인덱스 블록에 삽입할 인덱스 항목의 공간을 예약하기 위해 인덱스 생성시에만 사용합니다. 인덱스 항목은 갱신되지 않으며 키 열이 갱신될 때 인덱스 항목의 논리적 삭제 및 삽입이 발생합니다.
시스템이 생성한 송장 번호와 같이 차례대로 증가하는 열의 인덱스에는 낮은 PCTFREE를 사용합니다. 이러한 경우에는 항상 새로운 인덱스를 기존 인덱스 뒤에 추가하므로 새 항목을 기존의 두 인덱스 항목 사이에 삽입할 필요가 없습니다.
삽입하는 행의 인덱스화된 열 값이 임의의 값, 즉 현재 값의 범위에 포함되는 값일 수 있는 경우에는 높은 PCTFREE를 제공해야 합니다. 높은 PCTFREE를 필요로 하는 인덱스의 예로 송장 테이블의 고객 코드 열에 대한 인덱스를 들 수 있는데 이러한 경우에는 다음 공식에서구한 값으로 PCTFREE의 값을 지정하는 것이 좋습니다.
Maximum number of rows – Initial number of rows x 100
------------------------------------------------------------------
Maximum number of rows
최대값은 1년과 같은 특정 기간을 참조할 수 있습니다.
> 보통 전체 데이터의 10% 만을 사용(but 화면에 200~300개 출력해 쓰는 것을 권장)
> 몇 만개 단위시 index를 쓰지 않음.
> index size < table size
비트맵 인덱스 생성
구문
다음 명령을 사용하여 비트맵 인덱스를 생성합니다.
CREATE BITMAP INDEX [schema.] index
ON [schema.] table
(column [ ASC | DESC ] [ , column [ASC | DESC ] ] ...)
[ TABLESPACE tablespace ]
[ PCTFREE integer ]
[ INITRANS integer ]
[ MAXTRANS integer ]
[ storage-clause ]
[ LOGGING| NOLOGGING ]
[ NOSORT ]
비트맵 인덱스는 고유할 수 없습니다.
CREATE_BITMAP_AREA_SIZE매개변수
초기화 매개변수인 CREATE_BITMAP_AREA_SIZE는 비트맵 세그먼트를 메모리에 저장하
는 데 사용하는 공간의 양을 결정하며 기본값은 8MB입니다. 값이 클수록 인덱스를 빨리 생
성할 수 있고 기수가 아주 작은 경우에는 이 값을 작은 값으로 설정할 수 있습니다. 예를 들
어, 기수가 겨우 2이면 값을 MB가 아닌 KB 순서로 나열하며 일반적으로 기수가 높은 경우
에는 메모리가 충분해야 최적의 성능을 낼 수 있습니다.
인덱스 저장 영역 매개변수 변경
일부 저장 영역 매개변수 및 블록 활용 매개변수는 ALTER INDEX 명령을 사용하여 수정합니다.
구문
ALTER INDEX [schema.]index
[ storage-clause ]
[ INITRANS integer ]
[ MAXTRANS integer ]
인덱스 저장 영역 매개변수를 변경한 결과는 테이블 저장 영역 매개변수를 변경한 결과와동일하며 이러한 변경은 주로 인덱스의 MAXEXTENTS를 늘리는 데 사용합니다.
인덱스 블록의 동시성 레벨을 높이기 위해 블록 활용 매개변수를 변경하는 경우도 있습니다.
> 위 구문은 Local management 가 auto 이기 때문에 storage를 설정 해주지 않음
인덱스 공간 할당 및 할당 해제
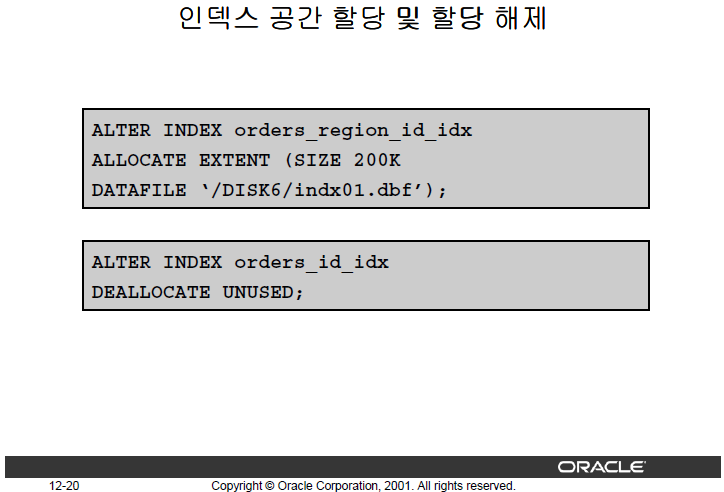
인덱스에수동으로공간할당:
테이블에 대한 대량의 삽입 작업 기간 전에 인덱스에 확장 영역을 추가해야 할 수 있으며
확장 영역을 추가하면 인덱스가 동적으로 확장되어 성능 저하를 방지할 수 있습니다.
인덱스에서수동으로공간할당해제
ALTER INDEX 명령의 DEALLOCATE 절을 사용하여 인덱스에서 고수위 이상의 사용되지 않은 공간을 해제합니다.
구문
다음 명령을 사용하여 인덱스 공간을 할당하거나 할당을 해제합니다.
ALTER INDEX [schema.]index
{ALLOCATE EXTENT ([SIZE integer [K|M]]
[ DATAFILE ‘filename’ ])
| DEALLOCATE UNUSED [KEEP integer [ K|M ] ] }
수동의 인덱스 공간 할당 작업 및 수동의 할당 해제 작업은 테이블에서 이 명령을 사용할
경우와 동일한 규칙을 따릅니다.
인덱스 재구축
인덱스 재구축에는 다음 특성이 있습니다.
• 기존 인덱스를 데이터 소스로 사용하여 새 인덱스를 구축합니다.
• 기존 인덱스를 사용하여 인덱스를 구축할 경우에는 정렬이 필요하지 않으므로 성능이 향상됩니다.
• 새 인덱스를 구축하고 나면 이전 인덱스는 삭제되며 재구축 중에는 이전 인덱스 및 새 인덱스를 각 테이블스페이스에 모두 수용할 수 있는 충분한 공간이 필요합니다.
• 결과 인덱스는 삭제한 항목을 포함하지 않으므로 이 인덱스는 공간을 더 효율적으로 사용합니다.
• 새 인덱스를 구축하는 동안에는 질의에서 기존 인덱스를 계속 사용할 수 있습니다.
재구축이 필요한 상황
다음 상황일 때 인덱스를 재구축합니다.
• 기존 인덱스를 다른 테이블스페이스로 이동해야 할 경우로 인덱스가 테이블과 동일한 테이블스페이스에 있거나 객체를 디스크에 재분배해야 할 경우에는 이 작업이 필요할 수 있습니다.
• 인덱스에 삭제한 항목이 많이 포함되어 있는 경우로 이러한 현상은 완료된 주문은 삭제하고 새로운 주문을 높은 번호로 테이블에 추가하는 주문 테이블의 주문 번호 인덱스와 같이 변하는 인덱스에서 나타나는 일반적인 문제입니다. 오래된 소수의 주문을아직 처리하지 않은 경우 항목 일부만 삭제한 인덱스 최하위 블록이 몇 개 있을 수도있습니다.
• 기존의 일반 인덱스를 역방향 키 인덱스로 변환해야 할 경우로 이전 릴리스의 Oracle 서버에서 응용 프로그램을 이전할 경우 재구축할 수 있습니다.
• 인덱스의 테이블을 ALTER TABLE ... MOVE TABLESPACE 명령을 사용하여 다른 테이블스페이스로 이동한 경우
구문
다음 명령을 사용하여 인덱스를 재구축합니다.
ALTER INDEX [schema.] index REBUILD
[ TABLESPACE tablespace ]
[ PCTFREE integer ]
[ INITRANS integer ]
[ MAXTRANS integer ]
[ storage-clause ]
[ LOGGING| NOLOGGING ]
[ REVERSE | NOREVERSE ]
ALTER INDEX ... REBUILD 명령은 비트맵 인덱스를 B 트리 인덱스로 바꾸거나 또는 그 반대인 경우 사용할 수 없으며 REVERSE 키워드 또는 NOREVERSE 키워드는 B 트리 인덱스에만 지정할 수 있습니다.
> 테이블의 move와 동일함
온라인으로 인덱스 재구축
인덱스 구축 또는 재구축 작업은 테이블이 아주 큰 경우 시간이 많이 걸리는 작업이며 Oracle8i 이전에는 인덱스를 생성 또는 재구축할 경우 테이블을 잠궈야 했고 동시 DML 작업을 할 수 없었습니다.
Oracle9i는 인덱스를 생성 또는 재생성하면서 기본 테이블에 대한 동시 작업을 수행할 수
있지만 이러한 절차 중에는 큰 DML 작업을 수행하지 않는 것이 좋습니다.
> 계속해서 DML 문이 잠겨 있으면 온라인 인덱스 구축 중에 다른 DDL 작업을 수행할 수 없음을 의미합니다.
제한사항
• 임시 테이블의 인덱스는 재구축할 수 없습니다.
• 분할된 인덱스 전체는 재구축할 수 없으므로 분할 영역 또는 서브 분할 영역을 각각 재구축해야 합니다.
• 사용되지 않은 공간은 할당을 해제할 수 없습니다.
• 해당 인덱스에 대한 PCTFREE 매개변수의 값을 전체적으로 변경할 수 없습니다.
> 대게 온라인 상태로 재구축을 하지 않음.
> 기존 인덱스는 두고 새로운 인덱스는 만드는 것 (원래 방식은 기존 인덱스를 지우고 새로 만드는 방법)
인덱스 병합
인덱스 단편화가 있는 경우 해당 인덱스를 재구축 또는 병합할 수 있으며 이러한 작업을 수행하기 전에 먼저 각 옵션의 비용 및 이익을 고려하여 자신의 상황에 가장 적합한 작업을 선택해야 합니다. 인덱스 병합은 온라인에서 수행되는 블록 재구축입니다.
재사용을 위해 공간을 늘릴 수 있는 B 트리 인덱스 최하위 블록이 있는 상황에서는 다음 SQL 문을 사용하여 이 최하위 블록을 병합할 수 있습니다.
SQL> ALTER INDEX hr.employees_idx COALESCE;
위 그림은 hr.employees_idx 인덱스에 대한 ALTER INDEX ∼ COALESCE의 영향을 보여 주고 있습니다. COALESCE 작업을 수행하기 전 첫번째 두 개의 최하위 블록은 50%가 채워진 상태입니다. 이것은 인덱스가 단편화되었으므로 병합되어 첫번째 블록을 모두 채 울 수 있고 단편화를 줄일 수 있다는 의미입니다.
인덱스 및 유효성 검사
인덱스를 분석하여 다음을 수행합니다.
• 모든 인덱스 블록에 대해 손상된 블록이 있는지 확인합니다. 이 명령을 수행해도 인덱스 항목이 테이블의 데이터에 대응되는지 여부는 확인되지 않습니다.
• INDEX_STATS 뷰를 인덱스 정보로 채웁니다.
구문
ANALYZE INDEX [ schema.]index VALIDATE STRUCTURE
이 명령을 실행한 후 다음 예제에 나타난 대로 INDEX_STATS를 질의하여 인덱스 정보를 얻습니다.
SQL> SELECT blocks, pct_used, distinct_keys
2 lf_rows, del_lf_rows
3 FROM index_stats;
BLOCKS PCT_USED LF_ROWS DEL_LF_ROWS
---------- ----------- ----------- -----------------
25 11 14 0
1 row selected.
인덱스에 삭제된 행의 비율이 높은 경우 해당 인덱스를 재구성합니다. 예를 들어,
DEL_LF_ROWS와 LF_ROWS의 비율이 30%를 초과하는 경우가 이에 해당합니다.
> 특정 Table의 딕셔너리 정보를 갱신 시켜줌
> DDL 명령어 (create, alter, drop, ..) -> 딕셔너리에 바로바로 정보를 갱신
> DML 명령어 (insert, delete, ....) -> 딕셔너리에 정보를 갱신 하지 않음
인덱스 삭제
다음 시나리오에서는 인덱스를 삭제해야 할 필요가 있습니다.
• 응용 프로그램에서 더 이상 사용하지 않는 인덱스는 삭제할 수 있습니다.
• 대량 로드를 수행하기 전에 인덱스를 삭제할 수 있으며 데이터를 대량으로 로드 하기 전에 인덱스를 삭제하고 로드한 다음 다시 생성하면 다음 결과를 얻을 수 있습니다.
– 로드 성능이 향상됩니다.
– 인덱스 공간을 더 효율적으로 사용할 수 있습니다.
• 주기적으로만 사용하는 인덱스가 특히 휘발성 테이블에 기반을 두고 있을 경우에는 불필요하게 유지 관리하지 않아도 되며 대개 연말 또는 분기 말의 검토 회의에 사용할 정보를 모으기 위해 임시 질의를 생성하는 OLTP 시스템의 경우에는불필요하게 유지 관리하지 않아도 됩니다.
• 로드 작업 같은 특정 유형의 작업 중에 인스턴스 실패가 발생하는 경우에는 인덱스를 INVALID로 표시하는데 이러한 경우에는 인덱스를 삭제하고 다시 생성해야 합니다.
• 인덱스가 훼손된 경우
제약 조건에 필요한 인덱스는 삭제할 수 없으므로 종속된 제약 조건을 비활성화하거나 삭
제해야 합니다.
사용되지 않은 인덱스 식별
Oracle9i부터는 인덱스 사용에 대한 통계를 수집하여 V$OBJECT_USAGE에 표시할 수 있습니다. 수집된 정보를 통해 인덱스가 사용되지 않았다는 것이 확인되면 해당 인덱스를 삭제할 수 있습니다. 또한 사용되지 않은 인덱스를 제거하면 Oracle 서버가 DML에 대해 수행해야 하는 오버헤드를 방지할 수 있으므로 성능이 향상됩니다. MONITORING USAGE 절이 지정될 때마다 V$OBJECT_USAGE가 지정된 인덱스에 대해 재설정됩니다. 이전 정보는 지워지거나 재설정되고 새로운 시작 시간이 기록됩니다.
V$OBJECT_USAGE 열
INDEX_NAME: 인덱스 이름입니다.
TABLE_NAME: 해당 테이블입니다.
MONITORING: 모니터를 ON으로 설정할지 OFF로 설정할지 여부를 나타냅니다.
USED: 모니터하는 동안 인덱스가 사용되었는지 여부를 YES 또는 NO로 나타냅니다.
START_MONITORING: 인덱스에 대한 모니터의 시작 시간을 나타냅니다.
END_MONITORING: 인덱스에 대한 모니터의 중지 시간을 나타냅니다.
2015년 3월 19일 목요일
오라클의 개념_11
프로파일
프로파일은 다음 암호 및 자원 제한을 명명한 집합입니다.
• 암호 만기일 기능 및 암호 만기
• 암호 기록
• 암호 복잡성 확인
• 계정 잠금
• CPU 시간
• I/O(입출력) 작업
• 휴지 시간
• 연결 시간
• 메모리 공간(공유 서버만을 위한 전용 SQL 영역)
• 동시 세션
프로파일을 생성하면 데이터베이스 관리자가 이를 각 사용자에게 할당할 수 있으며 자원
제한을 활성화하면 Oracle 서버는 해당 사용자에게 정의한 프로파일에 따라 데이터베이스
사용 및 자원을 제한합니다.
Oracle 서버는 데이터베이스 생성 시 DEFAULT 프로파일을 자동으로 생성합니다.
특정 프로파일에 명시적으로 할당되지 않은 사용자는 DEFAULT 프로파일의 모든 제한을
따르는데 처음에는 모든 DEFAULT 프로파일에 제한이 없지만 데이터베이스 관리자는 기
본적으로 모든 사용자에게 제한을 적용하도록 값을 변경할 수 있습니다.
프로파일용도
• 자원을 많이 사용해야 하는 일부 작업을 사용자가 수행할 수 없도록 제한합니다.
• 사용자의 세션이 일정 시간 동안 휴지 상태면 데이터베이스를 로그오프하도록 합니다.
• 유사한 사용자에 대한 그룹 자원 제한을 활성화합니다.
• 사용자에게 자원 제한을 쉽게 할당합니다.
• 대용량의 복잡한 다중 사용자 데이터베이스 시스템에서 자원 사용을 관리합니다.
• 암호 사용을 제어합니다.
프로파일특성 • 프로파일 할당은 현재 세션에 영향을 주지 않습니다.
• 프로파일은 사용자에게만 할당할 수 있고 롤 또는 다른 프로파일에는 할당할 수 없습니다.
• 사용자 생성 시 프로파일을 할당하지 않으면 DEFAULT 프로파일을 자동으로 할당합니다.
암호 관리
데이터베이스 보안을 철저히 관리하기 위해 데이터베이스 관리자는 프로파일을 사용하여
Oracle 암호 관리를 제어합니다.
이 단원에서는 사용 가능한 암호 관리 기능에 대해 설명합니다.
• 계정 잠금: 사용자가 지정한 시도 횟수 내에 시스템에 로그인하지 못하면 계정을 자동으로 잠글 수 있습니다.
• 암호 만기일 기능 및 암호 만기: 암호에 실행 주기가 있어 암호가 만료되면 바꾸어야 합니다.
• 암호 기록: 지정한 기간 또는 암호 변경 횟수 동안 암호를 재사용하지 않았는지 확인하기 위해 새 암호를 검사합니다.
• 암호 복잡성 확인: 암호를 추측하여 시스템에 침입하려고 하는 침입자를 방지할 수 있을 만큼 암호가 복잡한지 확인하기 위해 암호의 복잡성을 검사합니다.
암호 관리 활성화
CREATE USER 또는 ALTER USER 명령을 사용하여 암호 설정을 제한할 프로파일을 생성
한 다음 해당 프로파일을 사용자에게 할당합니다.
프로파일 내의 암호 제한 설정은 항상 시행합니다.
암호 관리를 활성화한 상태에서 CREATE USER 또는 ALTER USER 명령을 사용하여 사용자계정을 잠그거나 잠금을 해제할 수 있습니다.
암호 계정 잠금
FAILED_LOGIN_ATTEMPTS 값에 도달하면 Oracle 서버가 자동으로 계정을 잠그며 이 계
정은 PASSWORD_LOCK_TIME이 정의한 시간이 지나면 자동으로 잠금을 해제하거나 또는 데이터베이스 관리자가 ALTER USER 명령을 사용하여 잠금을 해제해야 합니다.
데이터베이스 계정은 ALTER USER 명령을 사용하여 명시적으로 잠글 수 있으며 이 경우에는 계정 잠금을 자동으로 해제하지 않습니다.
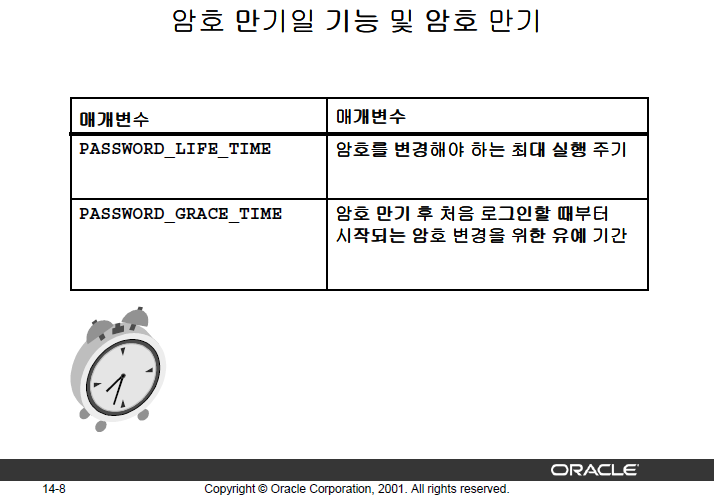
암호 만기일 기능 및 암호 만기
PASSWORD_LIFE_TIME 매개변수는 암호를 변경해야 하는 최대 실행 주기를 설정합니다.
데이터베이스 관리자는 암호 만기 후 처음으로 해당 데이터베이스에 로그인할 때부터 시
작되는 유예 기간(PASSWORD_GRACE_TIME)을 지정할 수 있는데 이 유예 기간이 지날 때
까지는 사용자가 로그인하려고 할 때마다 경고 메시지를 생성하므로 유예 기간 안에 암호
를 변경합니다.
암호를 바꾸지 않으면 계정을 사용할 수 없습니다.
명시적으로 암호를 만료한 것으로 설정하여 사용자 계정 상태를 EXPIRED로 변경합니다.
> PASSWORD_LIFE_TIME은 경고만 이며 계정을 제한 하지 않음.
> PASSWORD_GRACE_TIME은 해당 기간 동안 경고 후 제한
암호 기록
암호 기록 검사는 사용자가 지정한 기간 동안 암호를 재사용할 수 없음을 확인하며 이러한 검사는 다음 중 하나를 사용하여 수행합니다.
• PASSWORD_REUSE_TIME: 주어진 일 수 동안 암호를 재사용할 수 없도록 지정하려면 PASSWORD_REUSE_TIME을 사용합니다.
• PASSWORD_REUSE_MAX: 사용자에게 이전 암호와 다른 암호를 정의하도록 하려면 PASSWORD_REUSE_MAX를 사용합니다. > 암호 변경 가능 횟수
매개변수를 DEFAULT 또는 UNLIMITED 외의 값으로 설정한 경우에는 다른 매개변수를
UNLIMITED로 설정해야 합니다.
암호 확인
사용자에게 새 암호를 할당하기 전에 PL/SQL 함수를 호출하여 해당 암호의 유효성을 확인 할 수 있습니다.
Oracle 서버가 기본 확인 루틴을 제공하거나 데이터베이스 관리자가 PL/SQL 함수를 작성 할 수 있습니다.
사용자 제공 암호 함수
새 암호 확인 함수를 추가할 경우 데이터베이스 관리자는 다음 제한 사항을 고려해야 합니다.
• 프로시저는 슬라이드에 표시한 사양을 사용해야 합니다.
• 프로시저는 성공인 경우 TRUE 값을, 실패인 경우 FALSE 값을 반환합니다.
• 암호 함수에서 예외 사항이 발생하면 오류를 반환하면서 ALTER USER 또는 CREATE USER 명령을 종료합니다.
• 암호 함수는 SYS 소유입니다.
• 암호 함수가 사용할 수 없게 되면 오류 메시지가 반환되며 ALTER USER 또는 CREATE USER 명령이 종료됩니다.
> BOOLEAN Type 이므로 1일 때는 사용 가능, 0일 때는 사용 불가
암호 확인 함수
Oracle 서버는 utlpwdmg.sql 스크립트에 의해 VERIFY_FUNCTION이라고 하는 기본
PL/SQL 함수 형태로 복잡성 확인 함수를 제공하며 이 함수는 SYS 스키마에서 실행합니다.
utlpwdmg.sql 스크립트를 실행하는 동안 Oracle 서버는 VERIFY_FUNCTION을 생성한
후 다음 ALTER PROFILE 명령을 사용하여 DEFAULT 프로파일을 변경합니다.
SQL> ALTER PROFILE DEFAULT LIMIT
2 PASSWORD_LIFE_TIME 60
3 PASSWORD_GRACE_TIME 10
4 PASSWORD_REUSE_TIME 1800
5 PASSWORD_REUSE_MAX UNLIMITED
6 FAILED_LOGIN_ATTEMPTS 3
7 PASSWORD_LOCK_TIME 1/1440
8 PASSWORD_VERIFY_FUNCTION verify_function;
프로파일 생성
다음 CREATE PROFILE 명령을 사용하여 암호를 관리합니다.
CREATE PROFILE profile LIMIT
[FAILED_LOGIN_ATTEMPTS max_value]
[PASSWORD_LIFE_TIME max_value]
[ {PASSWORD_REUSE_TIME
|PASSWORD_REUSE_MAX} max_value]
[PASSWORD_LOCK_TIME max_value]
[PASSWORD_GRACE_TIME max_value]
[PASSWORD_VERIFY_FUNCTION
{function|NULL|DEFAULT} ]
설명
PROFILE: 생성할 프로파일 이름입니다.
FAILED_LOGIN_ATTEMPTS: 사용자 계정을 잠그기 전에 사용자 계정으로 로그인 시도를 실패할 수 있는 횟수를 지정합니다.
PASSWORD_LIFE_TIME: 인증을 위해 동일한 암호를 사용할 수 있는 일 수를 제한하는데 이 기간 내에 암호를 바꾸지 않으면 암호가 만료되어 이후 연결을 거부합니다.
PASSWORD_REUSE_TIME: 암호를 재사용할 수 있게 될 때까지의 일 수를 지정하는데 PASSWORD_REUSE_TIME을 정수 값으로 설정한 경우에는 PASSWORD_REUSE_MAX를UNLIMITED로 설정해야 합니다.
PASSWORD_REUSE_MAX: 현재 암호를 재사용할 수 있기 전에 필요한 암호 변경 횟수를 지정하는데 PASSWORD_REUSE_MAX를 정수 값으로 설정한 경우에는 PASSWORD_REUSE_TIME을 UNLIMITED로 설정해야 합니다.
PASSWORD_LOCK_TIME: 지정된 로그인 연속 실패 횟수 이후 계정을 잠그는 일 수를 지정합니다.
PASSWORD_GRACE_TIME: 경고는 표시하지만 로그인을 허용하는 유예 기간 일 수를 지정하는데 유예 기간 동안 암호를 바꾸지 않으면 암호가 만료됩니다.
PASSWORD_VERIFY_FUNCTION: PL/SQL 암호 복잡성 확인 함수를 CREATE PROFILE 문에 인수로 전달하도록 합니다.
프로파일 변경
ALTER PROFILE 명령을 사용하여 프로파일에 지정한 암호 제한을 변경할 수 있습니다.
ALTER PROFILE profile LIMIT
[FAILED_LOGIN_ATTEMPTS max_value]
[PASSWORD_LIFE_TIME max_value]
[ {PASSWORD_REUSE_TIME
|PASSWORD_REUSE_MAX} max_value]
[PASSWORD_LOCK_TIME max_value]
[PASSWORD_GRACE_TIME max_value]
[PASSWORD_VERIFY_FUNCTION
{function|NULL|DEFAULT} ]
암호 매개변수를 하루 미만으로 설정하려는 경우:
1시간: PASSWORD_LOCK_TIME = 1/24
10분: PASSWORD_LOCK_TIME = 10/1400
5분: PASSWORD_LOCK_TIME = 5/1440
프로파일 삭제 : 암호 설정
DROP PROFILE 명령을 사용하여 프로파일을 삭제합니다.
DROP PROFILE profile [CASCADE]
설명:
profile: 삭제할 프로파일 이름입니다.
CASCADE: 프로파일을 할당한 사용자로부터 프로파일을 취소합니다. (Oracle 서버는 이러
한 사용자에게 DEFAULT 프로파일을 자동으로 할당하며 이 옵션을 지정하여 사용자에게
현재 할당되어 있는 프로파일을 삭제합니다.)
지침
• DEFAULT 프로파일은 삭제할 수 없습니다.
• 프로파일 삭제 시 변경 사항은 나중에 생성하는 세션에만 적용되고 현재 세션에는 적용되지 않습니다.
자원관리
다음 단계를 사용하여 프로파일로 자원의 사용을 제어합니다.
1. CREATE PROFILE 명령으로 프로파일을 생성하여 자원 및 암호 제한을 결정합니다.
2. CREATE USER 또는 ALTER USER 명령을 사용하여 프로파일을 할당합니다.
3. ALTER SYSTEM 명령을 사용하거나 초기화 매개변수 파일을 편집한 다음 인스턴스를 정지하고 재시작하여 자원 제한을 시행합니다.
이러한 단계는 다음 부분에서 상세하게 설명합니다.
자원 제한 활성화
RESOURCE_LIMIT 초기화 매개변수를 변경하거나 ALTER SYSTEM 명령을 사용하여 자원 제한 시행을 활성화 또는 비활성화합니다.
RESOURCE_LIMIT초기화매개변수
• 자원 제한 시행을 활성화 또는 비활성화하려면 초기화 파일에서 이 매개변수를 변경한 다음 인스턴스를 재시작합니다.
• TRUE 값은 시행을 활성화합니다.
• FALSE 값은 시행을 비활성화합니다. (기본값)
• 이 매개변수를 사용하여 강제 시행 구조를 활성화합니다.
• Use this parameter to enable enforcement architecture.
ALTER SYSTEM명령
• 인스턴스에 대한 자원 제한 시행을 활성화 또는 비활성화하려면 ALTER SYSTEM 명령을사용합니다.
• ALTER SYSTEM 명령을 사용하여 지정한 설정은 다시 변경하거나 해당 데이터 베이스를 종료할 때까지 유효합니다.
• 데이터베이스를 종료할 수 없을 경우에는 이 명령을 사용하여 시행을 활성화 또는 비활성화합니다.
세션 레벨에서 자원 제한 설정
지침
프로파일 제한은 세션 레벨, 호출 레벨 또는 두 레벨 모두에서 시행할 수 있는데 세션 레벨제한은 연결할 때마다 시행합니다.
세션 레벨 제한 초과
• 다음과 같은 오류 메시지를 반환합니다.
ORA-02391: exceeded simultaneous SESSION_PER_USER limit
• Oracle 서버는 사용자 연결을 해제합니다.
지침
• IDLE_TIME은 서버 프로세스만 계산하고 응용 프로그램 작업은 고려하지 않으며 장시간 실행하는 질의 및 다른 작업은 IDLE_TIME에 영향을 주지 않습니다.
• LOGICAL_READS_PER_SESSION은 메모리 및 디스크에서의 전체 읽기 횟수를 제한하며 I/O 집중 명령문이 메모리를 과도하게 사용하거나 디스크를 독점하여 사용할 수 없도록 합니다.
• PRIVATE_SGA는 공유 서버 구조를 실행할 때만 적용하며 MB 또는 KB로 지정할 수 있습니다.
호출 레벨에서 자원 제한 설정
호출 레벨 제한은 SQL 문 실행 중에 호출할 때마다 시행합니다.
호출 레벨 제한 초과
• 명령문 처리를 중지합니다.
• 명령문을 롤백합니다.
• 이전 명령문은 모두 그대로 남아 있습니다.
• 사용자의 세션은 연결한 상태로 남아 있습니다.
프로파일 생성 : 자원 제한
다음 CREATE PROFILE 명령을 사용하여 프로파일을 생성합니다.
CREATE PROFILE profile LIMIT
[SESSIONS_PER_USER max_value]
[CPU_PER_SESSION max_value]
[CPU_PER_CALL max_value]
[CONNECT_TIME max_value]
[IDLE_TIME max_value]
[LOGICAL_READS_PER_SESSION max_value]
[LOGICAL_READS_PER_CALL max_value]
[COMPOSITE_LIMIT max_value]
[PRIVATE_SGA max_bytes]
설명:
profile: 프로파일 이름입니다.
max_value: 정수로 UNLIMITED 또는 DEFAULT입니다.
max_bytes: 선택적으로 뒤에 KB 또는 MB가 붙는 정수로 UNLIMITED 또는 DEFAULT입
니다.
UNLIMITED: 이 프로파일을 할당받은 사용자는 이 자원을 무제한 사용할 수 있음을
나타냅니다.
DEFAULT: DEFAULT 프로파일에서 지정한 대로 이 프로파일은 이 자원에 대해 제한
함을 나타냅니다.
COMPOSITE_LIMIT: 서비스 단위로 표현한 세션에 대해 전체 자원 비용을 제한하며
Oracle은 다음 가중 합계로서 자원 비용을 계산합니다.
– CPU_PER_SESSION
– CONNECT_TIME
– LOGICAL_READS_PER_SESSION
– PRIVATE_SGA
RESOURCE_COST 데이터 딕셔너리 뷰는 다른 자원에 할당한 자원 제한을 제공합니다.
암호 및 자원 제한 정보 얻기
DBA_USERS를 사용하여 계정 상태에 대한 정보를 얻을 수 있습니다.
SQL> SELECT username, password, account_status,
2 FROM dba_users;
USERNAME PASSWORD ACCOUNT_STATUS
------------- ----------------------- ----------------------
SYS 8A8F025737A9097A OPEN
SYSTEM D4DF7931AB130E37 OPEN
OUTLN 4A3BA55E08595C81 OPEN
DBSNMP E066D214D5421CCC OPEN
HR BB69FBB77CFA6B9A OPEN
OE 957C7EF29CC223FC LOCKED
---------------------------------------------------------------------------------------------------
실습
1. Profile 조회
* 명령어
SELECT DISTINCT PROFILE FROM DBA_PROFILES;
- Profile의 목록을 확인하는 명령어
SELECT * FROM DBA_PROFILES
ORDER BY RESOURCE_TYPE;
- 각 Profile에 정의된 설정 값을 확인 하는 명령어
SELECT USERNAME, PROFILE FROM DBA_USERS;
- 각 User에게 할당된 Profile을 조회하는 명령어
모든 사용자가 DEFAULT Profile에 따라 제한됨
(Default 는 파일명으로 Profile이 지정 되지 않았을 때 자동으로 지정)
2. Profile 생성과 제한 설정
Profile 설정은 password와 리소스 두부분으로 나누어지는데 이중 리소스 관련 설정은 resource_limit가 반드시 true로 정의 되었을 때 유효함.
CREATE PROFILE
- UNLIMITED : 제한을 두지 않음.
- DEFAULT : DEFAULT profile과 동일한 값을 가짐
COMPOSITE_LIMT [<설정값> | UNLIMITED | DEFAULT]
- COMPOSITE_LIMIT : CONNECT_TIME, PRIVATE_SGA, CPU_PER_SESSION, READ_PER_SESSION 등의 값을 통해서 제한 함.
SESSION_PER_USER [<설정값> | UNLIMITED | DEFAULT]
- SESSION_PER_USER : 계정 당 접속 가능한 세션 숫자.
PRIVATE_SGA [<설정값> | UNLIMITED | DEFAULT]
- PRIVATE_SGA : Shared server 환경에서 SGA에 사용가능한 SP 전용 메모리 크기 (MB)
CONNECT_TIME [<설정값> | UNLIMITED | DEFAULT]
- CONNECT_TIME : 접속 유효 시간 (분 단위)
IDLE_TIME [<설정값> | UNLIMITED | DEFAULT]
- IDLE_TIME : 비활성(아무런 행동 없이) 접속 한계 (분 단위)
LOGICAL_READS_PER_CALL [<설정값> | UNLIMITED | DEFAULT]
- LOGICAL_READS_PER_CALL : 한 문장에서 읽기 가능한 block 개수
LOGICAL_READS_PER_SESSION [<설정값> | UNLIMITED | DEFAULT]
- LOGICAL_READS_PER_SESSION : 한 session에서 읽기 가능한 block 개수
CPU_PER_CALL [<설정값> | UNLIMITED | DEFAULT]
- CPU_PER_CALL : 한 문장에서 사용 가능한 CPU 시간 (1/100초)
CPU_PER_SESSION [<설정값> | UNLIMITED | DEFAULT]
- CPU_PER_SESSION : 한 session에서 사용 가능한 CPU 시간 (1/100초)
PASSWORD_VERIFY_FUNCTION [<설정값> | UNLIMITED | DEFAULT]
- PASSWORD_VERIFY_FUNCTION : Password 복잡성을 확인 하는 함수
PASSWORD_REUSE_MAX [<설정값> | UNLIMITED | DEFAULT]
- PASSWORD_REUSE_MAX : Password 재사용 가능까지 Password를 변경해야 하는 횟수
PASSWORD_REUSE_TIME [<설정값> | UNLIMITED | DEFAULT]
- PASSWORD_REUSE_TIME : Password 재사용 가능까지 제한 하는 시간
PASSWORD_LIFE_TIME [<설정값> | UNLIMITED | DEFAULT]
- PASSWORD_LIFE_TIME : Password의 유효 기간
FAILED_LOGIN_ATTEMPTS [<설정값> | UNLIMITED | DEFAULT]
- FAILED_LOGIN_ATTEMPTS : Password 오류(잘못입력) 연속 허용 횟수
PASSWORD_LOCK_TIME [<설정값> | UNLIMITED | DEFAULT]
- PASSWORD_LOCK_TIME : Password 오류에 의해 Lock이 유지 되는 시간 (일 단위)
PASSWORD_GRACE_TIME [<설정값> | UNLIMITED | DEFAULT]
- PASSWORD_GRACE_TIME : Password 만료 이후 암호 변경 까지 유예 기간 (일 단위)
-Profile에 대한 ALTER 문장은 create 문장과 동일함.
SHOW PARAMETER resource_limit;
ALTER SYSTEM SET resource_limit=true;
SHOW PARAMETER resource_limit;
create profile insa limit
sessions_per_user 1
idle_time 5
CONNECT_time 10;
SELECT * FROM dba_profiles
WHERE profile = 'INSA'
ORDER BY 3;
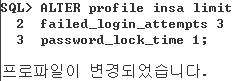
ALTER profile insa limit
failed_login_attempts 3
password_lock_time 1;
SELECT * FROM dba_profiles
WHERE profile = 'INSA'
ORDER BY 3;
3. Profile 할당과 적용
ALTER USER
PROFILE
- 사용자에게 profile을 할당함
- CREATE USER 명령을 통해 할당하는 것
- User에 Profile을 지정하지 않으면 default profile에 적용을 받음
create tablespace insa
datafile '/app/ora11g/oradata//insa01.dbf' SIZE 10M;
명령어를 통해 테이블 스페이스 생성
create user insa
IDENTIFIED BY insa
default tablespace insa
temporary tablespace temp
명령어를 통해 유저를 생성
SELECT username, profile FROM dba_users;
ALTER USER insa
profile insa;
- insa profile을 할당함
SELECT username, profile FROM dba_users;
insa 유저의 profile이 insa로 바뀐 것을 확인 가능
동시 접속을 1로 지정하였기에 동시에 동일한 계정이 두 세션으로 접속하면 lock이 걸림
두 번째 접속 하는 것은 접속이 되지 않음
비밀 번호를 세번 틀리게 접속시 계정이 rock에 걸리게 설정하였음
select username, account_status from dba_users;
접속 상태를 확인 한 결과 LOCK으로 일정 시간이 지나면 계정이 활성화 되도록 함
ALTER 문을 이용해 언락 상태로 계정을 사용 가능하게 바꿔줌
피드 구독하기:
글 (Atom)